
Unit 6: Advantage Actor Critic (A2C) using Robotics Simulations with Panda-Gym 🤖
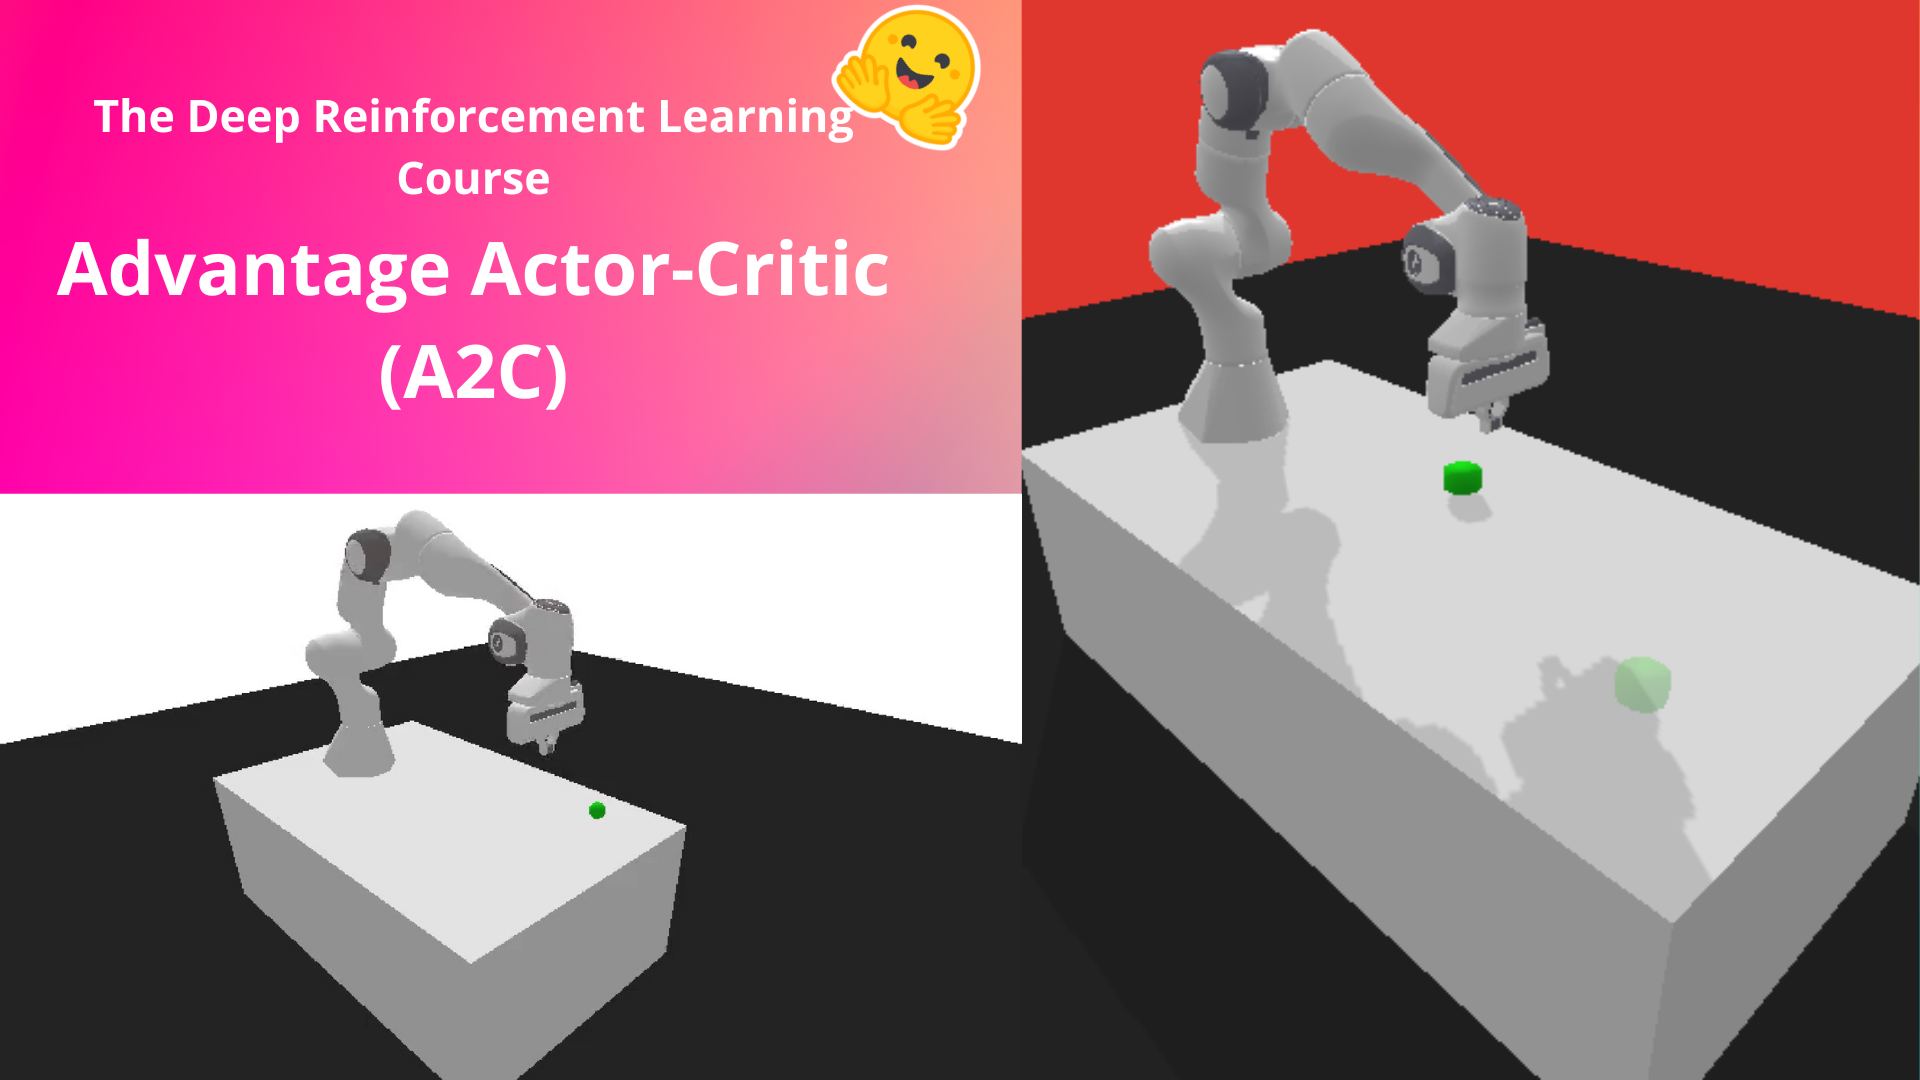
In this notebook, you'll learn to use A2C with Panda-Gym. You're going to train a robotic arm (Franka Emika Panda robot) to perform a task:
Reach: the robot must place its end-effector at a target position.
After that, you'll be able to train in other robotics tasks.
We're constantly trying to improve our tutorials, so if you find some issues in this notebook, please open an issue on the GitHub Repo.
Objectives of this notebook 🏆
At the end of the notebook, you will:
- Be able to use Panda-Gym, the environment library.
- Be able to train robots using A2C.
- Understand why we need to normalize the input.
- Be able to push your trained agent and the code to the Hub with a nice video replay and an evaluation score 🔥.
This notebook is from the Deep Reinforcement Learning Course
In this free course, you will:
- 📖 Study Deep Reinforcement Learning in theory and practice.
- 🧑💻 Learn to use famous Deep RL libraries such as Stable Baselines3, RL Baselines3 Zoo, CleanRL and Sample Factory 2.0.
- 🤖 Train agents in unique environments
And more check 📚 the syllabus 👉 https://simoninithomas.github.io/deep-rl-course
Don’t forget to sign up to the course (we are collecting your email to be able to send you the links when each Unit is published and give you information about the challenges and updates).
The best way to keep in touch is to join our discord server to exchange with the community and with us 👉🏻 https://discord.gg/ydHrjt3WP5
Prerequisites 🏗️
Before diving into the notebook, you need to:
🔲 📚 Study Actor-Critic methods by reading Unit 6 🤗
Let's train our first robots 🤖
To validate this hands-on for the certification process, you need to push your trained model to the Hub and get the following results:
PandaReachDense-v3get a result of >= -3.5.
To find your result, go to the leaderboard and find your model, the result = mean_reward - std of reward
For more information about the certification process, check this section 👉 https://huggingface.co/deep-rl-course/en/unit0/introduction#certification-process
Set the GPU 💪
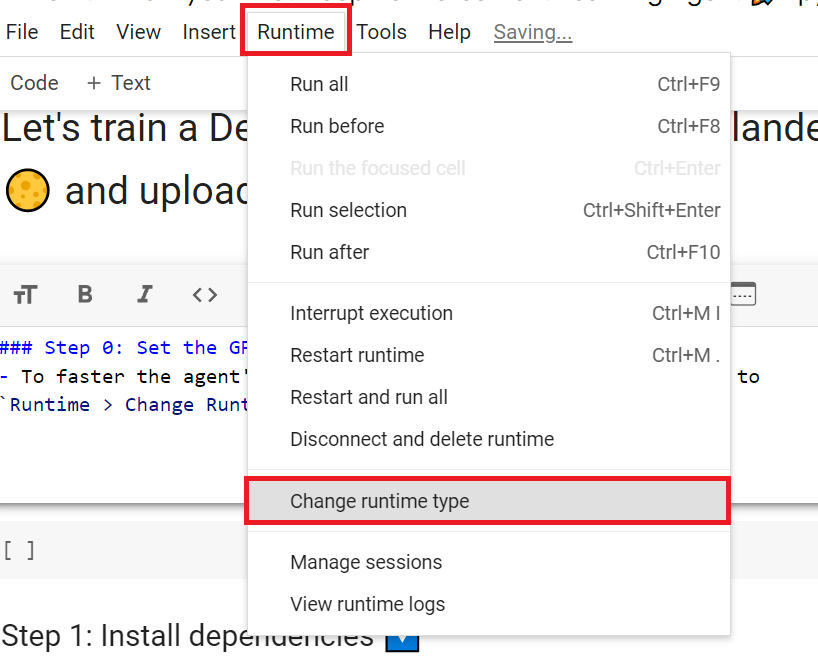
- To accelerate the agent's training, we'll use a GPU. To do that, go to
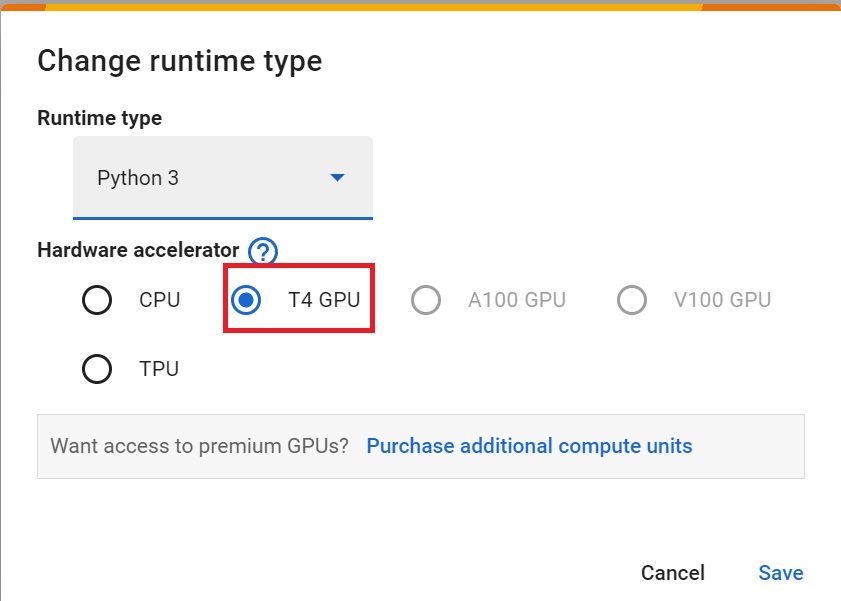
Runtime > Change Runtime type
Hardware Accelerator > GPU
Create a virtual display 🔽
During the notebook, we'll need to generate a replay video. To do so, with colab, we need to have a virtual screen to be able to render the environment (and thus record the frames).
Hence the following cell will install the librairies and create and run a virtual screen 🖥
%%capture
!apt install python-opengl
!apt install ffmpeg
!apt install xvfb
!pip3 install pyvirtualdisplay
# Virtual display
from pyvirtualdisplay import Display

virtual_display = Display(visible=0, size=(1400, 900))
virtual_display.start()
<pyvirtualdisplay.display.Display at 0x79a5b407f6b0>
Install dependencies 🔽
The first step is to install the dependencies, we’ll install multiple ones:
gymnasiumpanda-gym: Contains the robotics arm environments.stable-baselines3: The SB3 deep reinforcement learning library.huggingface_sb3: Additional code for Stable-baselines3 to load and upload models from the Hugging Face 🤗 Hub.huggingface_hub: Library allowing anyone to work with the Hub repositories.
⏲ The installation can take 10 minutes.
!pip install stable-baselines3[extra]
!pip install gymnasium
Requirement already satisfied: stable-baselines3[extra] in /usr/local/lib/python3.12/dist-packages (2.7.1)
Requirement already satisfied: gymnasium<1.3.0,>=0.29.1 in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (1.2.3)
Requirement already satisfied: numpy<3.0,>=1.20 in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (2.0.2)
Requirement already satisfied: torch<3.0,>=2.3 in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (2.9.0+cu126)
Requirement already satisfied: cloudpickle in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (3.1.2)
Requirement already satisfied: pandas in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (2.2.2)
Requirement already satisfied: matplotlib in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (3.10.0)
Requirement already satisfied: opencv-python in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (4.13.0.90)
Requirement already satisfied: pygame in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (2.6.1)
Requirement already satisfied: tensorboard>=2.9.1 in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (2.19.0)
Requirement already satisfied: psutil in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (5.9.5)
Requirement already satisfied: tqdm in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (4.67.2)
Requirement already satisfied: rich in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (13.9.4)
Requirement already satisfied: ale-py>=0.9.0 in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (0.11.2)
Requirement already satisfied: pillow in /usr/local/lib/python3.12/dist-packages (from stable-baselines3[extra]) (11.3.0)
Requirement already satisfied: typing-extensions>=4.3.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium<1.3.0,>=0.29.1->stable-baselines3[extra]) (4.15.0)
Requirement already satisfied: farama-notifications>=0.0.1 in /usr/local/lib/python3.12/dist-packages (from gymnasium<1.3.0,>=0.29.1->stable-baselines3[extra]) (0.0.4)
Requirement already satisfied: absl-py>=0.4 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (1.4.0)
Requirement already satisfied: grpcio>=1.48.2 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (1.76.0)
Requirement already satisfied: markdown>=2.6.8 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (3.10.1)
Requirement already satisfied: packaging in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (26.0)
Requirement already satisfied: protobuf!=4.24.0,>=3.19.6 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (5.29.5)
Requirement already satisfied: setuptools>=41.0.0 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (75.2.0)
Requirement already satisfied: six>1.9 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (1.17.0)
Requirement already satisfied: tensorboard-data-server<0.8.0,>=0.7.0 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (0.7.2)
Requirement already satisfied: werkzeug>=1.0.1 in /usr/local/lib/python3.12/dist-packages (from tensorboard>=2.9.1->stable-baselines3[extra]) (3.1.5)
Requirement already satisfied: filelock in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (3.20.3)
Requirement already satisfied: sympy>=1.13.3 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (1.14.0)
Requirement already satisfied: networkx>=2.5.1 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (3.6.1)
Requirement already satisfied: jinja2 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (3.1.6)
Requirement already satisfied: fsspec>=0.8.5 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (2025.3.0)
Requirement already satisfied: nvidia-cuda-nvrtc-cu12==12.6.77 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.77)
Requirement already satisfied: nvidia-cuda-runtime-cu12==12.6.77 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.77)
Requirement already satisfied: nvidia-cuda-cupti-cu12==12.6.80 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.80)
Requirement already satisfied: nvidia-cudnn-cu12==9.10.2.21 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (9.10.2.21)
Requirement already satisfied: nvidia-cublas-cu12==12.6.4.1 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.4.1)
Requirement already satisfied: nvidia-cufft-cu12==11.3.0.4 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (11.3.0.4)
Requirement already satisfied: nvidia-curand-cu12==10.3.7.77 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (10.3.7.77)
Requirement already satisfied: nvidia-cusolver-cu12==11.7.1.2 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (11.7.1.2)
Requirement already satisfied: nvidia-cusparse-cu12==12.5.4.2 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.5.4.2)
Requirement already satisfied: nvidia-cusparselt-cu12==0.7.1 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (0.7.1)
Requirement already satisfied: nvidia-nccl-cu12==2.27.5 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (2.27.5)
Requirement already satisfied: nvidia-nvshmem-cu12==3.3.20 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (3.3.20)
Requirement already satisfied: nvidia-nvtx-cu12==12.6.77 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.77)
Requirement already satisfied: nvidia-nvjitlink-cu12==12.6.85 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (12.6.85)
Requirement already satisfied: nvidia-cufile-cu12==1.11.1.6 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (1.11.1.6)
Requirement already satisfied: triton==3.5.0 in /usr/local/lib/python3.12/dist-packages (from torch<3.0,>=2.3->stable-baselines3[extra]) (3.5.0)
Requirement already satisfied: contourpy>=1.0.1 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (1.3.3)
Requirement already satisfied: cycler>=0.10 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (0.12.1)
Requirement already satisfied: fonttools>=4.22.0 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (4.61.1)
Requirement already satisfied: kiwisolver>=1.3.1 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (1.4.9)
Requirement already satisfied: pyparsing>=2.3.1 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (3.3.2)
Requirement already satisfied: python-dateutil>=2.7 in /usr/local/lib/python3.12/dist-packages (from matplotlib->stable-baselines3[extra]) (2.9.0.post0)
Requirement already satisfied: pytz>=2020.1 in /usr/local/lib/python3.12/dist-packages (from pandas->stable-baselines3[extra]) (2025.2)
Requirement already satisfied: tzdata>=2022.7 in /usr/local/lib/python3.12/dist-packages (from pandas->stable-baselines3[extra]) (2025.3)
Requirement already satisfied: markdown-it-py>=2.2.0 in /usr/local/lib/python3.12/dist-packages (from rich->stable-baselines3[extra]) (4.0.0)
Requirement already satisfied: pygments<3.0.0,>=2.13.0 in /usr/local/lib/python3.12/dist-packages (from rich->stable-baselines3[extra]) (2.19.2)
Requirement already satisfied: mdurl~=0.1 in /usr/local/lib/python3.12/dist-packages (from markdown-it-py>=2.2.0->rich->stable-baselines3[extra]) (0.1.2)
Requirement already satisfied: mpmath<1.4,>=1.1.0 in /usr/local/lib/python3.12/dist-packages (from sympy>=1.13.3->torch<3.0,>=2.3->stable-baselines3[extra]) (1.3.0)
Requirement already satisfied: markupsafe>=2.1.1 in /usr/local/lib/python3.12/dist-packages (from werkzeug>=1.0.1->tensorboard>=2.9.1->stable-baselines3[extra]) (3.0.3)
Requirement already satisfied: gymnasium in /usr/local/lib/python3.12/dist-packages (1.2.3)
Requirement already satisfied: numpy>=1.21.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium) (2.0.2)
Requirement already satisfied: cloudpickle>=1.2.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium) (3.1.2)
Requirement already satisfied: typing-extensions>=4.3.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium) (4.15.0)
Requirement already satisfied: farama-notifications>=0.0.1 in /usr/local/lib/python3.12/dist-packages (from gymnasium) (0.0.4)
!pip install huggingface_sb3
!pip install huggingface_hub
!pip install panda_gym
Requirement already satisfied: huggingface_sb3 in /usr/local/lib/python3.12/dist-packages (3.0)
Requirement already satisfied: huggingface-hub~=0.8 in /usr/local/lib/python3.12/dist-packages (from huggingface_sb3) (0.36.2)
Requirement already satisfied: pyyaml~=6.0 in /usr/local/lib/python3.12/dist-packages (from huggingface_sb3) (6.0.3)
Requirement already satisfied: wasabi in /usr/local/lib/python3.12/dist-packages (from huggingface_sb3) (1.1.3)
Requirement already satisfied: numpy in /usr/local/lib/python3.12/dist-packages (from huggingface_sb3) (2.0.2)
Requirement already satisfied: cloudpickle>=1.6 in /usr/local/lib/python3.12/dist-packages (from huggingface_sb3) (3.1.2)
Requirement already satisfied: filelock in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (3.20.3)
Requirement already satisfied: fsspec>=2023.5.0 in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (2025.3.0)
Requirement already satisfied: hf-xet<2.0.0,>=1.1.3 in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (1.2.0)
Requirement already satisfied: packaging>=20.9 in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (26.0)
Requirement already satisfied: requests in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (2.32.4)
Requirement already satisfied: tqdm>=4.42.1 in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (4.67.2)
Requirement already satisfied: typing-extensions>=3.7.4.3 in /usr/local/lib/python3.12/dist-packages (from huggingface-hub~=0.8->huggingface_sb3) (4.15.0)
Requirement already satisfied: charset_normalizer<4,>=2 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface-hub~=0.8->huggingface_sb3) (3.4.4)
Requirement already satisfied: idna<4,>=2.5 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface-hub~=0.8->huggingface_sb3) (3.11)
Requirement already satisfied: urllib3<3,>=1.21.1 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface-hub~=0.8->huggingface_sb3) (2.5.0)
Requirement already satisfied: certifi>=2017.4.17 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface-hub~=0.8->huggingface_sb3) (2026.1.4)
Requirement already satisfied: huggingface_hub in /usr/local/lib/python3.12/dist-packages (0.36.2)
Requirement already satisfied: filelock in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (3.20.3)
Requirement already satisfied: fsspec>=2023.5.0 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (2025.3.0)
Requirement already satisfied: hf-xet<2.0.0,>=1.1.3 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (1.2.0)
Requirement already satisfied: packaging>=20.9 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (26.0)
Requirement already satisfied: pyyaml>=5.1 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (6.0.3)
Requirement already satisfied: requests in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (2.32.4)
Requirement already satisfied: tqdm>=4.42.1 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (4.67.2)
Requirement already satisfied: typing-extensions>=3.7.4.3 in /usr/local/lib/python3.12/dist-packages (from huggingface_hub) (4.15.0)
Requirement already satisfied: charset_normalizer<4,>=2 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface_hub) (3.4.4)
Requirement already satisfied: idna<4,>=2.5 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface_hub) (3.11)
Requirement already satisfied: urllib3<3,>=1.21.1 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface_hub) (2.5.0)
Requirement already satisfied: certifi>=2017.4.17 in /usr/local/lib/python3.12/dist-packages (from requests->huggingface_hub) (2026.1.4)
Requirement already satisfied: panda_gym in /usr/local/lib/python3.12/dist-packages (3.0.7)
Requirement already satisfied: gymnasium>=0.26 in /usr/local/lib/python3.12/dist-packages (from panda_gym) (1.2.3)
Requirement already satisfied: pybullet in /usr/local/lib/python3.12/dist-packages (from panda_gym) (3.2.7)
Requirement already satisfied: numpy in /usr/local/lib/python3.12/dist-packages (from panda_gym) (2.0.2)
Requirement already satisfied: scipy in /usr/local/lib/python3.12/dist-packages (from panda_gym) (1.16.3)
Requirement already satisfied: cloudpickle>=1.2.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium>=0.26->panda_gym) (3.1.2)
Requirement already satisfied: typing-extensions>=4.3.0 in /usr/local/lib/python3.12/dist-packages (from gymnasium>=0.26->panda_gym) (4.15.0)
Requirement already satisfied: farama-notifications>=0.0.1 in /usr/local/lib/python3.12/dist-packages (from gymnasium>=0.26->panda_gym) (0.0.4)
Import the packages 📦
import os

import gymnasium as gym
import panda_gym

from huggingface_sb3 import load_from_hub, package_to_hub

from stable_baselines3 import A2C
from stable_baselines3.common.evaluation import evaluate_policy
from stable_baselines3.common.vec_env import DummyVecEnv, VecNormalize
from stable_baselines3.common.env_util import make_vec_env

from huggingface_hub import notebook_login
PandaReachDense-v3 🦾
The agent we're going to train is a robotic arm that needs to do controls (moving the arm and using the end-effector).
In robotics, the end-effector is the device at the end of a robotic arm designed to interact with the environment.
In PandaReach, the robot must place its end-effector at a target position (green ball).
We're going to use the dense version of this environment. It means we'll get a dense reward function that will provide a reward at each timestep (the closer the agent is to completing the task, the higher the reward). Contrary to a sparse reward function where the environment return a reward if and only if the task is completed.
Also, we're going to use the End-effector displacement control, it means the action corresponds to the displacement of the end-effector. We don't control the individual motion of each joint (joint control).
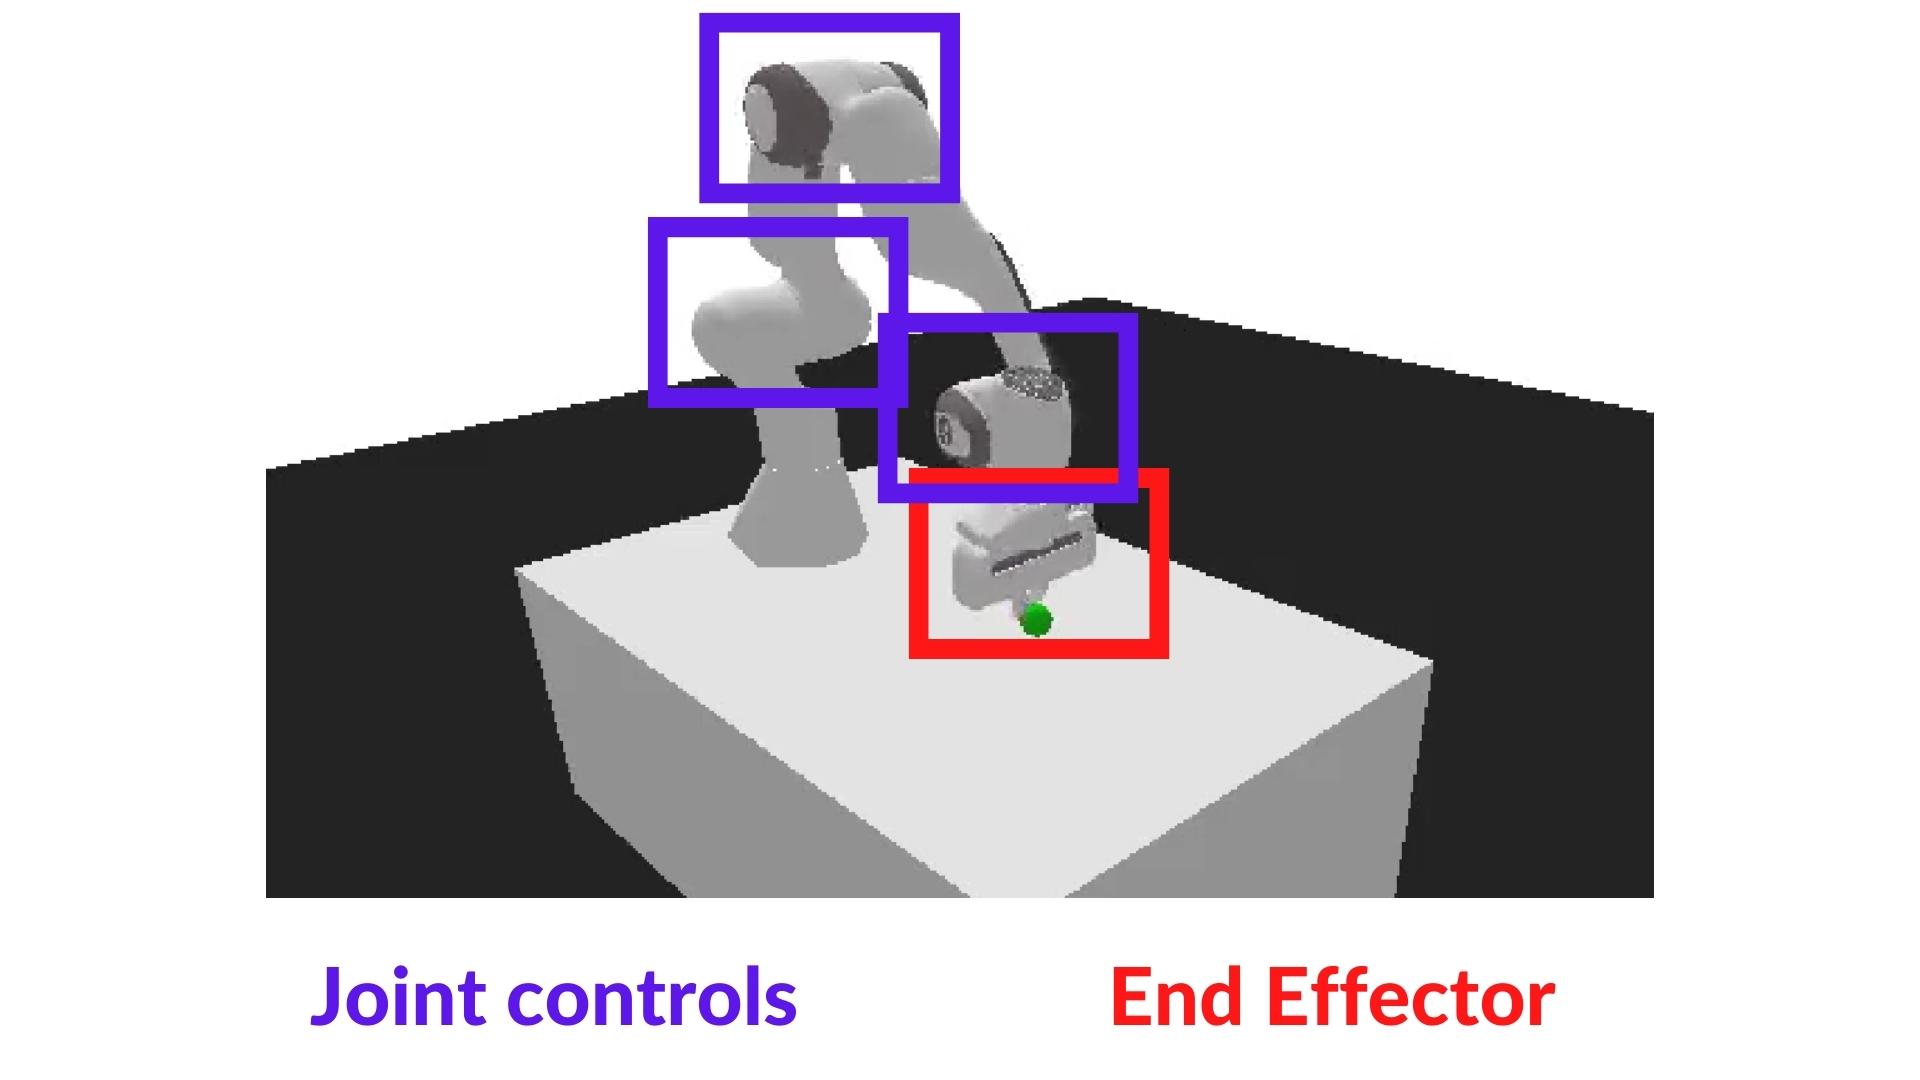
This way the training will be easier.
env_id = "PandaReachDense-v3"

# Create the env
env = gym.make(env_id)

# Get the state space and action space
s_size = env.observation_space.shape
a_size = env.action_space
print("_____OBSERVATION SPACE_____ \n")
print("The State Space is: ", s_size)
print("Sample observation", env.observation_space.sample()) # Get a random observation
_____OBSERVATION SPACE_____

The State Space is:  None
Sample observation {'achieved_goal': array([3.2657533, 5.5416384, 1.4957422], dtype=float32), 'desired_goal': array([-2.6892405,  6.4781384, -1.9908282], dtype=float32), 'observation': array([-9.6151   , -8.020906 , -4.9873276,  4.127711 , -8.096539 ,
       -4.40084  ], dtype=float32)}
The observation space is a dictionary with 3 different elements:
achieved_goal: (x,y,z) the current position of the end-effector.desired_goal: (x,y,z) the target position for the end-effector.observation: position (x,y,z) and velocity of the end-effector (vx, vy, vz).
Given it's a dictionary as observation, we will need to use a MultiInputPolicy policy instead of MlpPolicy.
print("\n _____ACTION SPACE_____ \n")
print("The Action Space is: ", a_size)
print("Action Space Sample", env.action_space.sample()) # Take a random action
 _____ACTION SPACE_____

The Action Space is:  Box(-1.0, 1.0, (3,), float32)
Action Space Sample [-0.46053746  0.1423268   0.36900496]
The action space is a vector with 3 values:
- Control x, y, z movement
Normalize observation and rewards
A good practice in reinforcement learning is to normalize input features.
For that purpose, there is a wrapper that will compute a running average and standard deviation of input features.
We also normalize rewards with this same wrapper by adding norm_reward = True
env = make_vec_env(env_id, n_envs=4)

# Adding this wrapper to normalize the observation and the reward
env = VecNormalize(env, norm_obs=True, norm_reward=True, clip_obs=10.)
Create the A2C Model 🤖
For more information about A2C implementation with StableBaselines3 check: https://stable-baselines3.readthedocs.io/en/master/modules/a2c.html#notes
To find the best parameters I checked the official trained agents by Stable-Baselines3 team.
model = model = A2C(policy = "MultiInputPolicy",
                    env = env,
                    verbose=1)
Using cuda device
/usr/local/lib/python3.12/dist-packages/jupyter_client/session.py:203: DeprecationWarning: datetime.datetime.utcnow() is deprecated and scheduled for removal in a future version. Use timezone-aware objects to represent datetimes in UTC: datetime.datetime.now(datetime.UTC).
  return datetime.utcnow().replace(tzinfo=utc)
Train the A2C agent 🏃
- Let's train our agent for 1,000,000 timesteps, don't forget to use GPU on Colab. It will take approximately ~25-40min
model.learn(1_000_000)
Streaming output truncated to the last 5000 lines.
| std | 0.393 |
| value_loss | 0.000159 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 23800 |
| time_elapsed | 1088 |
| total_timesteps | 476000 |
| train/ | |
| entropy_loss | -1.26 |
| explained_variance | 0.933 |
| learning_rate | 0.0007 |
| n_updates | 23799 |
| policy_loss | -0.00549 |
| std | 0.394 |
| value_loss | 0.000213 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.202 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 23900 |
| time_elapsed | 1092 |
| total_timesteps | 478000 |
| train/ | |
| entropy_loss | -1.27 |
| explained_variance | 0.963 |
| learning_rate | 0.0007 |
| n_updates | 23899 |
| policy_loss | 0.00497 |
| std | 0.395 |
| value_loss | 0.000165 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24000 |
| time_elapsed | 1097 |
| total_timesteps | 480000 |
| train/ | |
| entropy_loss | -1.27 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 23999 |
| policy_loss | 0.000277 |
| std | 0.395 |
| value_loss | 0.000106 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.201 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24100 |
| time_elapsed | 1101 |
| total_timesteps | 482000 |
| train/ | |
| entropy_loss | -1.26 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 24099 |
| policy_loss | -0.0112 |
| std | 0.394 |
| value_loss | 9.58e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24200 |
| time_elapsed | 1106 |
| total_timesteps | 484000 |
| train/ | |
| entropy_loss | -1.23 |
| explained_variance | 0.936 |
| learning_rate | 0.0007 |
| n_updates | 24199 |
| policy_loss | -0.0314 |
| std | 0.39 |
| value_loss | 0.000468 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24300 |
| time_elapsed | 1111 |
| total_timesteps | 486000 |
| train/ | |
| entropy_loss | -1.21 |
| explained_variance | 0.937 |
| learning_rate | 0.0007 |
| n_updates | 24299 |
| policy_loss | 0.0177 |
| std | 0.387 |
| value_loss | 0.000499 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.82 |
| ep_rew_mean | -0.224 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24400 |
| time_elapsed | 1115 |
| total_timesteps | 488000 |
| train/ | |
| entropy_loss | -1.22 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 24399 |
| policy_loss | -0.000601 |
| std | 0.388 |
| value_loss | 5.9e-05 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.93 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24500 |
| time_elapsed | 1119 |
| total_timesteps | 490000 |
| train/ | |
| entropy_loss | -1.24 |
| explained_variance | 0.946 |
| learning_rate | 0.0007 |
| n_updates | 24499 |
| policy_loss | 0.00428 |
| std | 0.391 |
| value_loss | 0.000252 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.231 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24600 |
| time_elapsed | 1124 |
| total_timesteps | 492000 |
| train/ | |
| entropy_loss | -1.26 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 24599 |
| policy_loss | -0.00575 |
| std | 0.393 |
| value_loss | 0.000134 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24700 |
| time_elapsed | 1129 |
| total_timesteps | 494000 |
| train/ | |
| entropy_loss | -1.23 |
| explained_variance | 0.961 |
| learning_rate | 0.0007 |
| n_updates | 24699 |
| policy_loss | 0.00308 |
| std | 0.389 |
| value_loss | 0.000141 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24800 |
| time_elapsed | 1134 |
| total_timesteps | 496000 |
| train/ | |
| entropy_loss | -1.23 |
| explained_variance | 0.968 |
| learning_rate | 0.0007 |
| n_updates | 24799 |
| policy_loss | 0.0016 |
| std | 0.389 |
| value_loss | 0.000224 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.57 |
| ep_rew_mean | -0.196 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 24900 |
| time_elapsed | 1138 |
| total_timesteps | 498000 |
| train/ | |
| entropy_loss | -1.22 |
| explained_variance | 0.966 |
| learning_rate | 0.0007 |
| n_updates | 24899 |
| policy_loss | 0.00659 |
| std | 0.388 |
| value_loss | 0.000202 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25000 |
| time_elapsed | 1142 |
| total_timesteps | 500000 |
| train/ | |
| entropy_loss | -1.22 |
| explained_variance | 0.917 |
| learning_rate | 0.0007 |
| n_updates | 24999 |
| policy_loss | -0.00588 |
| std | 0.388 |
| value_loss | 0.000299 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25100 |
| time_elapsed | 1147 |
| total_timesteps | 502000 |
| train/ | |
| entropy_loss | -1.21 |
| explained_variance | 0.992 |
| learning_rate | 0.0007 |
| n_updates | 25099 |
| policy_loss | 0.0111 |
| std | 0.385 |
| value_loss | 9.25e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25200 |
| time_elapsed | 1151 |
| total_timesteps | 504000 |
| train/ | |
| entropy_loss | -1.2 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 25199 |
| policy_loss | 0.00253 |
| std | 0.385 |
| value_loss | 9.25e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25300 |
| time_elapsed | 1156 |
| total_timesteps | 506000 |
| train/ | |
| entropy_loss | -1.19 |
| explained_variance | 0.942 |
| learning_rate | 0.0007 |
| n_updates | 25299 |
| policy_loss | -0.0233 |
| std | 0.383 |
| value_loss | 0.000242 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25400 |
| time_elapsed | 1161 |
| total_timesteps | 508000 |
| train/ | |
| entropy_loss | -1.17 |
| explained_variance | 0.927 |
| learning_rate | 0.0007 |
| n_updates | 25399 |
| policy_loss | -0.00725 |
| std | 0.381 |
| value_loss | 0.000237 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25500 |
| time_elapsed | 1165 |
| total_timesteps | 510000 |
| train/ | |
| entropy_loss | -1.18 |
| explained_variance | 0.987 |
| learning_rate | 0.0007 |
| n_updates | 25499 |
| policy_loss | -0.016 |
| std | 0.383 |
| value_loss | 0.00012 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.92 |
| ep_rew_mean | -0.244 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25600 |
| time_elapsed | 1169 |
| total_timesteps | 512000 |
| train/ | |
| entropy_loss | -1.18 |
| explained_variance | 0.942 |
| learning_rate | 0.0007 |
| n_updates | 25599 |
| policy_loss | 0.0192 |
| std | 0.383 |
| value_loss | 0.000413 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25700 |
| time_elapsed | 1174 |
| total_timesteps | 514000 |
| train/ | |
| entropy_loss | -1.17 |
| explained_variance | 0.982 |
| learning_rate | 0.0007 |
| n_updates | 25699 |
| policy_loss | -0.00399 |
| std | 0.382 |
| value_loss | 8.4e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.202 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25800 |
| time_elapsed | 1179 |
| total_timesteps | 516000 |
| train/ | |
| entropy_loss | -1.15 |
| explained_variance | 0.96 |
| learning_rate | 0.0007 |
| n_updates | 25799 |
| policy_loss | 0.00677 |
| std | 0.38 |
| value_loss | 0.000241 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 25900 |
| time_elapsed | 1184 |
| total_timesteps | 518000 |
| train/ | |
| entropy_loss | -1.15 |
| explained_variance | 0.965 |
| learning_rate | 0.0007 |
| n_updates | 25899 |
| policy_loss | -0.00466 |
| std | 0.379 |
| value_loss | 0.000128 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26000 |
| time_elapsed | 1188 |
| total_timesteps | 520000 |
| train/ | |
| entropy_loss | -1.13 |
| explained_variance | 0.951 |
| learning_rate | 0.0007 |
| n_updates | 25999 |
| policy_loss | -0.00483 |
| std | 0.378 |
| value_loss | 0.000323 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.56 |
| ep_rew_mean | -0.193 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26100 |
| time_elapsed | 1192 |
| total_timesteps | 522000 |
| train/ | |
| entropy_loss | -1.1 |
| explained_variance | 0.979 |
| learning_rate | 0.0007 |
| n_updates | 26099 |
| policy_loss | 0.00312 |
| std | 0.374 |
| value_loss | 6.12e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26200 |
| time_elapsed | 1197 |
| total_timesteps | 524000 |
| train/ | |
| entropy_loss | -1.08 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 26199 |
| policy_loss | 0.00202 |
| std | 0.372 |
| value_loss | 6.13e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.68 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26300 |
| time_elapsed | 1201 |
| total_timesteps | 526000 |
| train/ | |
| entropy_loss | -1.06 |
| explained_variance | 0.979 |
| learning_rate | 0.0007 |
| n_updates | 26299 |
| policy_loss | 0.00539 |
| std | 0.369 |
| value_loss | 0.000151 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.63 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26400 |
| time_elapsed | 1206 |
| total_timesteps | 528000 |
| train/ | |
| entropy_loss | -1.04 |
| explained_variance | 0.869 |
| learning_rate | 0.0007 |
| n_updates | 26399 |
| policy_loss | -0.00282 |
| std | 0.367 |
| value_loss | 0.000337 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26500 |
| time_elapsed | 1211 |
| total_timesteps | 530000 |
| train/ | |
| entropy_loss | -1.05 |
| explained_variance | 0.892 |
| learning_rate | 0.0007 |
| n_updates | 26499 |
| policy_loss | 0.000418 |
| std | 0.367 |
| value_loss | 0.000721 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26600 |
| time_elapsed | 1215 |
| total_timesteps | 532000 |
| train/ | |
| entropy_loss | -1.03 |
| explained_variance | 0.98 |
| learning_rate | 0.0007 |
| n_updates | 26599 |
| policy_loss | -0.00692 |
| std | 0.364 |
| value_loss | 0.000104 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26700 |
| time_elapsed | 1220 |
| total_timesteps | 534000 |
| train/ | |
| entropy_loss | -1.01 |
| explained_variance | 0.98 |
| learning_rate | 0.0007 |
| n_updates | 26699 |
| policy_loss | -0.00222 |
| std | 0.361 |
| value_loss | 8.03e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.9 |
| ep_rew_mean | -0.235 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26800 |
| time_elapsed | 1224 |
| total_timesteps | 536000 |
| train/ | |
| entropy_loss | -0.991 |
| explained_variance | 0.979 |
| learning_rate | 0.0007 |
| n_updates | 26799 |
| policy_loss | 0.00704 |
| std | 0.359 |
| value_loss | 0.000233 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.225 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 26900 |
| time_elapsed | 1229 |
| total_timesteps | 538000 |
| train/ | |
| entropy_loss | -0.962 |
| explained_variance | 0.895 |
| learning_rate | 0.0007 |
| n_updates | 26899 |
| policy_loss | 0.00109 |
| std | 0.356 |
| value_loss | 0.00031 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.68 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27000 |
| time_elapsed | 1234 |
| total_timesteps | 540000 |
| train/ | |
| entropy_loss | -0.959 |
| explained_variance | 0.951 |
| learning_rate | 0.0007 |
| n_updates | 26999 |
| policy_loss | 0.000767 |
| std | 0.355 |
| value_loss | 0.000157 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27100 |
| time_elapsed | 1238 |
| total_timesteps | 542000 |
| train/ | |
| entropy_loss | -0.932 |
| explained_variance | 0.96 |
| learning_rate | 0.0007 |
| n_updates | 27099 |
| policy_loss | -0.00582 |
| std | 0.353 |
| value_loss | 0.000193 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.68 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27200 |
| time_elapsed | 1242 |
| total_timesteps | 544000 |
| train/ | |
| entropy_loss | -0.927 |
| explained_variance | 0.952 |
| learning_rate | 0.0007 |
| n_updates | 27199 |
| policy_loss | -0.00986 |
| std | 0.352 |
| value_loss | 0.000141 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27300 |
| time_elapsed | 1247 |
| total_timesteps | 546000 |
| train/ | |
| entropy_loss | -0.924 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 27299 |
| policy_loss | -0.00312 |
| std | 0.351 |
| value_loss | 0.000141 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.206 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27400 |
| time_elapsed | 1251 |
| total_timesteps | 548000 |
| train/ | |
| entropy_loss | -0.912 |
| explained_variance | 0.941 |
| learning_rate | 0.0007 |
| n_updates | 27399 |
| policy_loss | 0.0197 |
| std | 0.35 |
| value_loss | 0.000411 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.193 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27500 |
| time_elapsed | 1256 |
| total_timesteps | 550000 |
| train/ | |
| entropy_loss | -0.901 |
| explained_variance | 0.872 |
| learning_rate | 0.0007 |
| n_updates | 27499 |
| policy_loss | 0.00819 |
| std | 0.35 |
| value_loss | 0.000517 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.91 |
| ep_rew_mean | -0.231 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27600 |
| time_elapsed | 1261 |
| total_timesteps | 552000 |
| train/ | |
| entropy_loss | -0.902 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 27599 |
| policy_loss | 0.0022 |
| std | 0.351 |
| value_loss | 7.21e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.08 |
| ep_rew_mean | -0.256 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27700 |
| time_elapsed | 1265 |
| total_timesteps | 554000 |
| train/ | |
| entropy_loss | -0.895 |
| explained_variance | 0.945 |
| learning_rate | 0.0007 |
| n_updates | 27699 |
| policy_loss | 0.00365 |
| std | 0.349 |
| value_loss | 0.000178 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.226 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27800 |
| time_elapsed | 1270 |
| total_timesteps | 556000 |
| train/ | |
| entropy_loss | -0.889 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 27799 |
| policy_loss | 0.000683 |
| std | 0.349 |
| value_loss | 6.51e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 27900 |
| time_elapsed | 1274 |
| total_timesteps | 558000 |
| train/ | |
| entropy_loss | -0.89 |
| explained_variance | 0.975 |
| learning_rate | 0.0007 |
| n_updates | 27899 |
| policy_loss | 0.000131 |
| std | 0.349 |
| value_loss | 8.67e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28000 |
| time_elapsed | 1279 |
| total_timesteps | 560000 |
| train/ | |
| entropy_loss | -0.902 |
| explained_variance | 0.957 |
| learning_rate | 0.0007 |
| n_updates | 27999 |
| policy_loss | -0.00692 |
| std | 0.351 |
| value_loss | 0.000261 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28100 |
| time_elapsed | 1284 |
| total_timesteps | 562000 |
| train/ | |
| entropy_loss | -0.882 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 28099 |
| policy_loss | 0.00243 |
| std | 0.349 |
| value_loss | 0.000134 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.224 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28200 |
| time_elapsed | 1288 |
| total_timesteps | 564000 |
| train/ | |
| entropy_loss | -0.877 |
| explained_variance | 0.989 |
| learning_rate | 0.0007 |
| n_updates | 28199 |
| policy_loss | 0.000998 |
| std | 0.349 |
| value_loss | 9.85e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.223 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28300 |
| time_elapsed | 1293 |
| total_timesteps | 566000 |
| train/ | |
| entropy_loss | -0.875 |
| explained_variance | 0.967 |
| learning_rate | 0.0007 |
| n_updates | 28299 |
| policy_loss | -0.00425 |
| std | 0.349 |
| value_loss | 0.000124 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.97 |
| ep_rew_mean | -0.241 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28400 |
| time_elapsed | 1297 |
| total_timesteps | 568000 |
| train/ | |
| entropy_loss | -0.864 |
| explained_variance | 0.968 |
| learning_rate | 0.0007 |
| n_updates | 28399 |
| policy_loss | -0.00923 |
| std | 0.348 |
| value_loss | 0.000168 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28500 |
| time_elapsed | 1302 |
| total_timesteps | 570000 |
| train/ | |
| entropy_loss | -0.854 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 28499 |
| policy_loss | 0.00986 |
| std | 0.348 |
| value_loss | 0.000351 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28600 |
| time_elapsed | 1307 |
| total_timesteps | 572000 |
| train/ | |
| entropy_loss | -0.869 |
| explained_variance | 0.977 |
| learning_rate | 0.0007 |
| n_updates | 28599 |
| policy_loss | -0.00556 |
| std | 0.35 |
| value_loss | 0.000123 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.67 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28700 |
| time_elapsed | 1311 |
| total_timesteps | 574000 |
| train/ | |
| entropy_loss | -0.849 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 28699 |
| policy_loss | 0.00101 |
| std | 0.348 |
| value_loss | 0.000124 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.51 |
| ep_rew_mean | -0.185 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28800 |
| time_elapsed | 1315 |
| total_timesteps | 576000 |
| train/ | |
| entropy_loss | -0.826 |
| explained_variance | 0.962 |
| learning_rate | 0.0007 |
| n_updates | 28799 |
| policy_loss | 0.0027 |
| std | 0.346 |
| value_loss | 0.000202 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.64 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 28900 |
| time_elapsed | 1320 |
| total_timesteps | 578000 |
| train/ | |
| entropy_loss | -0.823 |
| explained_variance | 0.935 |
| learning_rate | 0.0007 |
| n_updates | 28899 |
| policy_loss | -0.0011 |
| std | 0.346 |
| value_loss | 0.000291 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29000 |
| time_elapsed | 1324 |
| total_timesteps | 580000 |
| train/ | |
| entropy_loss | -0.832 |
| explained_variance | 0.916 |
| learning_rate | 0.0007 |
| n_updates | 28999 |
| policy_loss | 0.0188 |
| std | 0.348 |
| value_loss | 0.0008 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29100 |
| time_elapsed | 1329 |
| total_timesteps | 582000 |
| train/ | |
| entropy_loss | -0.822 |
| explained_variance | 0.905 |
| learning_rate | 0.0007 |
| n_updates | 29099 |
| policy_loss | 0.00226 |
| std | 0.347 |
| value_loss | 0.000306 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.85 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29200 |
| time_elapsed | 1334 |
| total_timesteps | 584000 |
| train/ | |
| entropy_loss | -0.845 |
| explained_variance | 0.976 |
| learning_rate | 0.0007 |
| n_updates | 29199 |
| policy_loss | -0.00853 |
| std | 0.35 |
| value_loss | 0.000199 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.5 |
| ep_rew_mean | -0.187 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29300 |
| time_elapsed | 1338 |
| total_timesteps | 586000 |
| train/ | |
| entropy_loss | -0.85 |
| explained_variance | 0.942 |
| learning_rate | 0.0007 |
| n_updates | 29299 |
| policy_loss | -0.00359 |
| std | 0.351 |
| value_loss | 0.000333 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29400 |
| time_elapsed | 1343 |
| total_timesteps | 588000 |
| train/ | |
| entropy_loss | -0.85 |
| explained_variance | 0.91 |
| learning_rate | 0.0007 |
| n_updates | 29399 |
| policy_loss | -0.00646 |
| std | 0.351 |
| value_loss | 0.000917 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29500 |
| time_elapsed | 1347 |
| total_timesteps | 590000 |
| train/ | |
| entropy_loss | -0.823 |
| explained_variance | 0.964 |
| learning_rate | 0.0007 |
| n_updates | 29499 |
| policy_loss | -0.000433 |
| std | 0.347 |
| value_loss | 0.000107 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29600 |
| time_elapsed | 1351 |
| total_timesteps | 592000 |
| train/ | |
| entropy_loss | -0.809 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 29599 |
| policy_loss | -0.00582 |
| std | 0.346 |
| value_loss | 0.000183 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29700 |
| time_elapsed | 1356 |
| total_timesteps | 594000 |
| train/ | |
| entropy_loss | -0.795 |
| explained_variance | 0.91 |
| learning_rate | 0.0007 |
| n_updates | 29699 |
| policy_loss | 0.00652 |
| std | 0.345 |
| value_loss | 0.000201 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.207 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29800 |
| time_elapsed | 1361 |
| total_timesteps | 596000 |
| train/ | |
| entropy_loss | -0.781 |
| explained_variance | 0.987 |
| learning_rate | 0.0007 |
| n_updates | 29799 |
| policy_loss | 0.000131 |
| std | 0.343 |
| value_loss | 0.000137 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 29900 |
| time_elapsed | 1365 |
| total_timesteps | 598000 |
| train/ | |
| entropy_loss | -0.753 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 29899 |
| policy_loss | 0.00987 |
| std | 0.34 |
| value_loss | 0.000373 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.5 |
| ep_rew_mean | -0.187 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30000 |
| time_elapsed | 1370 |
| total_timesteps | 600000 |
| train/ | |
| entropy_loss | -0.746 |
| explained_variance | 0.961 |
| learning_rate | 0.0007 |
| n_updates | 29999 |
| policy_loss | 0.00575 |
| std | 0.339 |
| value_loss | 0.000303 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30100 |
| time_elapsed | 1374 |
| total_timesteps | 602000 |
| train/ | |
| entropy_loss | -0.747 |
| explained_variance | 0.991 |
| learning_rate | 0.0007 |
| n_updates | 30099 |
| policy_loss | -0.00798 |
| std | 0.339 |
| value_loss | 7.6e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30200 |
| time_elapsed | 1379 |
| total_timesteps | 604000 |
| train/ | |
| entropy_loss | -0.744 |
| explained_variance | 0.951 |
| learning_rate | 0.0007 |
| n_updates | 30199 |
| policy_loss | -0.00128 |
| std | 0.339 |
| value_loss | 0.000215 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30300 |
| time_elapsed | 1383 |
| total_timesteps | 606000 |
| train/ | |
| entropy_loss | -0.742 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 30299 |
| policy_loss | 0.00112 |
| std | 0.339 |
| value_loss | 5.82e-05 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.54 |
| ep_rew_mean | -0.187 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30400 |
| time_elapsed | 1388 |
| total_timesteps | 608000 |
| train/ | |
| entropy_loss | -0.757 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 30399 |
| policy_loss | -1.52e-05 |
| std | 0.342 |
| value_loss | 0.000118 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30500 |
| time_elapsed | 1393 |
| total_timesteps | 610000 |
| train/ | |
| entropy_loss | -0.746 |
| explained_variance | 0.966 |
| learning_rate | 0.0007 |
| n_updates | 30499 |
| policy_loss | -0.00121 |
| std | 0.34 |
| value_loss | 0.000156 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30600 |
| time_elapsed | 1397 |
| total_timesteps | 612000 |
| train/ | |
| entropy_loss | -0.724 |
| explained_variance | 0.979 |
| learning_rate | 0.0007 |
| n_updates | 30599 |
| policy_loss | -0.0068 |
| std | 0.338 |
| value_loss | 9.97e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 30700 |
| time_elapsed | 1401 |
| total_timesteps | 614000 |
| train/ | |
| entropy_loss | -0.705 |
| explained_variance | 0.982 |
| learning_rate | 0.0007 |
| n_updates | 30699 |
| policy_loss | -0.00225 |
| std | 0.336 |
| value_loss | 0.000157 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.57 |
| ep_rew_mean | -0.195 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30800 |
| time_elapsed | 1406 |
| total_timesteps | 616000 |
| train/ | |
| entropy_loss | -0.723 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 30799 |
| policy_loss | 0.00965 |
| std | 0.338 |
| value_loss | 0.000251 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 30900 |
| time_elapsed | 1411 |
| total_timesteps | 618000 |
| train/ | |
| entropy_loss | -0.716 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 30899 |
| policy_loss | -0.000958 |
| std | 0.337 |
| value_loss | 0.000142 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.207 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31000 |
| time_elapsed | 1416 |
| total_timesteps | 620000 |
| train/ | |
| entropy_loss | -0.724 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 30999 |
| policy_loss | -0.0017 |
| std | 0.338 |
| value_loss | 0.000169 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31100 |
| time_elapsed | 1420 |
| total_timesteps | 622000 |
| train/ | |
| entropy_loss | -0.686 |
| explained_variance | 0.931 |
| learning_rate | 0.0007 |
| n_updates | 31099 |
| policy_loss | -0.00646 |
| std | 0.333 |
| value_loss | 0.000637 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31200 |
| time_elapsed | 1424 |
| total_timesteps | 624000 |
| train/ | |
| entropy_loss | -0.665 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 31199 |
| policy_loss | 0.00762 |
| std | 0.332 |
| value_loss | 0.000328 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31300 |
| time_elapsed | 1429 |
| total_timesteps | 626000 |
| train/ | |
| entropy_loss | -0.66 |
| explained_variance | 0.985 |
| learning_rate | 0.0007 |
| n_updates | 31299 |
| policy_loss | 0.00206 |
| std | 0.331 |
| value_loss | 0.000223 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.195 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31400 |
| time_elapsed | 1433 |
| total_timesteps | 628000 |
| train/ | |
| entropy_loss | -0.641 |
| explained_variance | 0.941 |
| learning_rate | 0.0007 |
| n_updates | 31399 |
| policy_loss | -0.00248 |
| std | 0.329 |
| value_loss | 0.00028 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 31500 |
| time_elapsed | 1438 |
| total_timesteps | 630000 |
| train/ | |
| entropy_loss | -0.615 |
| explained_variance | 0.93 |
| learning_rate | 0.0007 |
| n_updates | 31499 |
| policy_loss | -0.0113 |
| std | 0.325 |
| value_loss | 0.000273 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31600 |
| time_elapsed | 1443 |
| total_timesteps | 632000 |
| train/ | |
| entropy_loss | -0.6 |
| explained_variance | 0.894 |
| learning_rate | 0.0007 |
| n_updates | 31599 |
| policy_loss | -0.00429 |
| std | 0.324 |
| value_loss | 0.00133 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.9 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 31700 |
| time_elapsed | 1447 |
| total_timesteps | 634000 |
| train/ | |
| entropy_loss | -0.608 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 31699 |
| policy_loss | -0.0024 |
| std | 0.325 |
| value_loss | 0.000123 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31800 |
| time_elapsed | 1452 |
| total_timesteps | 636000 |
| train/ | |
| entropy_loss | -0.6 |
| explained_variance | 0.874 |
| learning_rate | 0.0007 |
| n_updates | 31799 |
| policy_loss | -0.0424 |
| std | 0.324 |
| value_loss | 0.0149 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.61 |
| ep_rew_mean | -0.195 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 31900 |
| time_elapsed | 1456 |
| total_timesteps | 638000 |
| train/ | |
| entropy_loss | -0.582 |
| explained_variance | 0.954 |
| learning_rate | 0.0007 |
| n_updates | 31899 |
| policy_loss | 0.00211 |
| std | 0.322 |
| value_loss | 0.00049 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32000 |
| time_elapsed | 1460 |
| total_timesteps | 640000 |
| train/ | |
| entropy_loss | -0.609 |
| explained_variance | 0.962 |
| learning_rate | 0.0007 |
| n_updates | 31999 |
| policy_loss | 0.00319 |
| std | 0.324 |
| value_loss | 0.00018 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 437 |
| iterations | 32100 |
| time_elapsed | 1465 |
| total_timesteps | 642000 |
| train/ | |
| entropy_loss | -0.615 |
| explained_variance | 0.957 |
| learning_rate | 0.0007 |
| n_updates | 32099 |
| policy_loss | -0.00688 |
| std | 0.325 |
| value_loss | 0.000259 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.85 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32200 |
| time_elapsed | 1470 |
| total_timesteps | 644000 |
| train/ | |
| entropy_loss | -0.625 |
| explained_variance | 0.982 |
| learning_rate | 0.0007 |
| n_updates | 32199 |
| policy_loss | 0.00275 |
| std | 0.325 |
| value_loss | 0.00019 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32300 |
| time_elapsed | 1474 |
| total_timesteps | 646000 |
| train/ | |
| entropy_loss | -0.613 |
| explained_variance | 0.975 |
| learning_rate | 0.0007 |
| n_updates | 32299 |
| policy_loss | 0.0103 |
| std | 0.324 |
| value_loss | 0.00028 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32400 |
| time_elapsed | 1479 |
| total_timesteps | 648000 |
| train/ | |
| entropy_loss | -0.611 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 32399 |
| policy_loss | 0.000633 |
| std | 0.325 |
| value_loss | 0.000134 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32500 |
| time_elapsed | 1483 |
| total_timesteps | 650000 |
| train/ | |
| entropy_loss | -0.62 |
| explained_variance | 0.993 |
| learning_rate | 0.0007 |
| n_updates | 32499 |
| policy_loss | -0.000412 |
| std | 0.326 |
| value_loss | 7.44e-05 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.87 |
| ep_rew_mean | -0.225 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32600 |
| time_elapsed | 1487 |
| total_timesteps | 652000 |
| train/ | |
| entropy_loss | -0.617 |
| explained_variance | 0.977 |
| learning_rate | 0.0007 |
| n_updates | 32599 |
| policy_loss | -0.0108 |
| std | 0.326 |
| value_loss | 0.000391 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.96 |
| ep_rew_mean | -0.237 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32700 |
| time_elapsed | 1492 |
| total_timesteps | 654000 |
| train/ | |
| entropy_loss | -0.607 |
| explained_variance | 0.966 |
| learning_rate | 0.0007 |
| n_updates | 32699 |
| policy_loss | 0.0118 |
| std | 0.325 |
| value_loss | 0.000153 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.87 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32800 |
| time_elapsed | 1496 |
| total_timesteps | 656000 |
| train/ | |
| entropy_loss | -0.596 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 32799 |
| policy_loss | -0.00331 |
| std | 0.323 |
| value_loss | 0.000303 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 32900 |
| time_elapsed | 1501 |
| total_timesteps | 658000 |
| train/ | |
| entropy_loss | -0.575 |
| explained_variance | 0.479 |
| learning_rate | 0.0007 |
| n_updates | 32899 |
| policy_loss | 0.00108 |
| std | 0.321 |
| value_loss | 0.0131 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.231 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33000 |
| time_elapsed | 1506 |
| total_timesteps | 660000 |
| train/ | |
| entropy_loss | -0.564 |
| explained_variance | 0.969 |
| learning_rate | 0.0007 |
| n_updates | 32999 |
| policy_loss | -0.00147 |
| std | 0.319 |
| value_loss | 0.000223 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33100 |
| time_elapsed | 1510 |
| total_timesteps | 662000 |
| train/ | |
| entropy_loss | -0.563 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 33099 |
| policy_loss | -0.00193 |
| std | 0.319 |
| value_loss | 7.55e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.01 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33200 |
| time_elapsed | 1515 |
| total_timesteps | 664000 |
| train/ | |
| entropy_loss | -0.581 |
| explained_variance | 0.805 |
| learning_rate | 0.0007 |
| n_updates | 33199 |
| policy_loss | 0.0164 |
| std | 0.32 |
| value_loss | 0.0094 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33300 |
| time_elapsed | 1519 |
| total_timesteps | 666000 |
| train/ | |
| entropy_loss | -0.547 |
| explained_variance | 0.496 |
| learning_rate | 0.0007 |
| n_updates | 33299 |
| policy_loss | 0.0232 |
| std | 0.316 |
| value_loss | 0.00472 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.58 |
| ep_rew_mean | -0.189 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33400 |
| time_elapsed | 1523 |
| total_timesteps | 668000 |
| train/ | |
| entropy_loss | -0.551 |
| explained_variance | 0.591 |
| learning_rate | 0.0007 |
| n_updates | 33399 |
| policy_loss | -0.00674 |
| std | 0.317 |
| value_loss | 0.00272 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33500 |
| time_elapsed | 1528 |
| total_timesteps | 670000 |
| train/ | |
| entropy_loss | -0.56 |
| explained_variance | 0.851 |
| learning_rate | 0.0007 |
| n_updates | 33499 |
| policy_loss | -0.0127 |
| std | 0.318 |
| value_loss | 0.000922 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33600 |
| time_elapsed | 1533 |
| total_timesteps | 672000 |
| train/ | |
| entropy_loss | -0.539 |
| explained_variance | 0.953 |
| learning_rate | 0.0007 |
| n_updates | 33599 |
| policy_loss | 0.000557 |
| std | 0.316 |
| value_loss | 0.000312 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33700 |
| time_elapsed | 1538 |
| total_timesteps | 674000 |
| train/ | |
| entropy_loss | -0.538 |
| explained_variance | 0.668 |
| learning_rate | 0.0007 |
| n_updates | 33699 |
| policy_loss | -0.0112 |
| std | 0.316 |
| value_loss | 0.00231 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33800 |
| time_elapsed | 1542 |
| total_timesteps | 676000 |
| train/ | |
| entropy_loss | -0.529 |
| explained_variance | 0.989 |
| learning_rate | 0.0007 |
| n_updates | 33799 |
| policy_loss | 0.00283 |
| std | 0.315 |
| value_loss | 8.4e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 33900 |
| time_elapsed | 1546 |
| total_timesteps | 678000 |
| train/ | |
| entropy_loss | -0.493 |
| explained_variance | 0.804 |
| learning_rate | 0.0007 |
| n_updates | 33899 |
| policy_loss | -0.0242 |
| std | 0.311 |
| value_loss | 0.00196 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34000 |
| time_elapsed | 1551 |
| total_timesteps | 680000 |
| train/ | |
| entropy_loss | -0.501 |
| explained_variance | 0.913 |
| learning_rate | 0.0007 |
| n_updates | 33999 |
| policy_loss | -0.00392 |
| std | 0.313 |
| value_loss | 0.00104 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.67 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34100 |
| time_elapsed | 1555 |
| total_timesteps | 682000 |
| train/ | |
| entropy_loss | -0.493 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 34099 |
| policy_loss | -0.00167 |
| std | 0.311 |
| value_loss | 6.93e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.92 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34200 |
| time_elapsed | 1560 |
| total_timesteps | 684000 |
| train/ | |
| entropy_loss | -0.505 |
| explained_variance | 0.844 |
| learning_rate | 0.0007 |
| n_updates | 34199 |
| policy_loss | -0.00186 |
| std | 0.311 |
| value_loss | 0.00117 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34300 |
| time_elapsed | 1565 |
| total_timesteps | 686000 |
| train/ | |
| entropy_loss | -0.492 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 34299 |
| policy_loss | 0.000245 |
| std | 0.31 |
| value_loss | 0.000236 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34400 |
| time_elapsed | 1569 |
| total_timesteps | 688000 |
| train/ | |
| entropy_loss | -0.492 |
| explained_variance | 0.928 |
| learning_rate | 0.0007 |
| n_updates | 34399 |
| policy_loss | -0.000657 |
| std | 0.31 |
| value_loss | 0.000204 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34500 |
| time_elapsed | 1573 |
| total_timesteps | 690000 |
| train/ | |
| entropy_loss | -0.486 |
| explained_variance | 0.491 |
| learning_rate | 0.0007 |
| n_updates | 34499 |
| policy_loss | -0.00616 |
| std | 0.31 |
| value_loss | 0.0104 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.93 |
| ep_rew_mean | -0.233 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34600 |
| time_elapsed | 1578 |
| total_timesteps | 692000 |
| train/ | |
| entropy_loss | -0.498 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 34599 |
| policy_loss | 0.00325 |
| std | 0.311 |
| value_loss | 0.000203 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34700 |
| time_elapsed | 1582 |
| total_timesteps | 694000 |
| train/ | |
| entropy_loss | -0.499 |
| explained_variance | 0.909 |
| learning_rate | 0.0007 |
| n_updates | 34699 |
| policy_loss | -0.00991 |
| std | 0.311 |
| value_loss | 0.000361 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34800 |
| time_elapsed | 1587 |
| total_timesteps | 696000 |
| train/ | |
| entropy_loss | -0.501 |
| explained_variance | 0.967 |
| learning_rate | 0.0007 |
| n_updates | 34799 |
| policy_loss | 2.16e-05 |
| std | 0.312 |
| value_loss | 0.000159 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 34900 |
| time_elapsed | 1591 |
| total_timesteps | 698000 |
| train/ | |
| entropy_loss | -0.501 |
| explained_variance | 0.96 |
| learning_rate | 0.0007 |
| n_updates | 34899 |
| policy_loss | -0.00241 |
| std | 0.312 |
| value_loss | 0.000264 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35000 |
| time_elapsed | 1596 |
| total_timesteps | 700000 |
| train/ | |
| entropy_loss | -0.488 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 34999 |
| policy_loss | -8.19e-05 |
| std | 0.311 |
| value_loss | 0.000166 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.82 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35100 |
| time_elapsed | 1601 |
| total_timesteps | 702000 |
| train/ | |
| entropy_loss | -0.49 |
| explained_variance | 0.985 |
| learning_rate | 0.0007 |
| n_updates | 35099 |
| policy_loss | -0.00591 |
| std | 0.311 |
| value_loss | 0.000251 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.89 |
| ep_rew_mean | -0.224 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35200 |
| time_elapsed | 1605 |
| total_timesteps | 704000 |
| train/ | |
| entropy_loss | -0.49 |
| explained_variance | 0.967 |
| learning_rate | 0.0007 |
| n_updates | 35199 |
| policy_loss | -0.00436 |
| std | 0.311 |
| value_loss | 0.000114 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35300 |
| time_elapsed | 1609 |
| total_timesteps | 706000 |
| train/ | |
| entropy_loss | -0.495 |
| explained_variance | 0.961 |
| learning_rate | 0.0007 |
| n_updates | 35299 |
| policy_loss | 0.0042 |
| std | 0.312 |
| value_loss | 0.000594 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.207 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35400 |
| time_elapsed | 1614 |
| total_timesteps | 708000 |
| train/ | |
| entropy_loss | -0.492 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 35399 |
| policy_loss | -0.000209 |
| std | 0.312 |
| value_loss | 0.000234 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35500 |
| time_elapsed | 1618 |
| total_timesteps | 710000 |
| train/ | |
| entropy_loss | -0.478 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 35499 |
| policy_loss | 0.000504 |
| std | 0.311 |
| value_loss | 0.000159 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35600 |
| time_elapsed | 1623 |
| total_timesteps | 712000 |
| train/ | |
| entropy_loss | -0.451 |
| explained_variance | 0.927 |
| learning_rate | 0.0007 |
| n_updates | 35599 |
| policy_loss | 0.00686 |
| std | 0.309 |
| value_loss | 0.000377 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.67 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35700 |
| time_elapsed | 1627 |
| total_timesteps | 714000 |
| train/ | |
| entropy_loss | -0.436 |
| explained_variance | 0.992 |
| learning_rate | 0.0007 |
| n_updates | 35699 |
| policy_loss | -0.00229 |
| std | 0.307 |
| value_loss | 6.88e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.81 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35800 |
| time_elapsed | 1632 |
| total_timesteps | 716000 |
| train/ | |
| entropy_loss | -0.419 |
| explained_variance | 0.929 |
| learning_rate | 0.0007 |
| n_updates | 35799 |
| policy_loss | -0.00254 |
| std | 0.306 |
| value_loss | 0.000322 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 35900 |
| time_elapsed | 1637 |
| total_timesteps | 718000 |
| train/ | |
| entropy_loss | -0.42 |
| explained_variance | 0.956 |
| learning_rate | 0.0007 |
| n_updates | 35899 |
| policy_loss | 0.00148 |
| std | 0.305 |
| value_loss | 0.000364 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36000 |
| time_elapsed | 1641 |
| total_timesteps | 720000 |
| train/ | |
| entropy_loss | -0.406 |
| explained_variance | 0.969 |
| learning_rate | 0.0007 |
| n_updates | 35999 |
| policy_loss | -0.00107 |
| std | 0.305 |
| value_loss | 0.000294 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36100 |
| time_elapsed | 1645 |
| total_timesteps | 722000 |
| train/ | |
| entropy_loss | -0.394 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 36099 |
| policy_loss | -0.000425 |
| std | 0.304 |
| value_loss | 0.000122 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.224 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36200 |
| time_elapsed | 1650 |
| total_timesteps | 724000 |
| train/ | |
| entropy_loss | -0.408 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 36199 |
| policy_loss | 0.0047 |
| std | 0.305 |
| value_loss | 0.000156 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.85 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36300 |
| time_elapsed | 1654 |
| total_timesteps | 726000 |
| train/ | |
| entropy_loss | -0.419 |
| explained_variance | 0.991 |
| learning_rate | 0.0007 |
| n_updates | 36299 |
| policy_loss | 0.00399 |
| std | 0.305 |
| value_loss | 9.81e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.6 |
| ep_rew_mean | -0.192 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36400 |
| time_elapsed | 1659 |
| total_timesteps | 728000 |
| train/ | |
| entropy_loss | -0.397 |
| explained_variance | 0.883 |
| learning_rate | 0.0007 |
| n_updates | 36399 |
| policy_loss | -0.00127 |
| std | 0.302 |
| value_loss | 0.000543 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.85 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36500 |
| time_elapsed | 1663 |
| total_timesteps | 730000 |
| train/ | |
| entropy_loss | -0.41 |
| explained_variance | 0.924 |
| learning_rate | 0.0007 |
| n_updates | 36499 |
| policy_loss | 0.0049 |
| std | 0.303 |
| value_loss | 0.000676 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36600 |
| time_elapsed | 1668 |
| total_timesteps | 732000 |
| train/ | |
| entropy_loss | -0.395 |
| explained_variance | 0.992 |
| learning_rate | 0.0007 |
| n_updates | 36599 |
| policy_loss | 0.00327 |
| std | 0.301 |
| value_loss | 8.71e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36700 |
| time_elapsed | 1673 |
| total_timesteps | 734000 |
| train/ | |
| entropy_loss | -0.384 |
| explained_variance | 0.938 |
| learning_rate | 0.0007 |
| n_updates | 36699 |
| policy_loss | 0.00192 |
| std | 0.301 |
| value_loss | 0.000366 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36800 |
| time_elapsed | 1677 |
| total_timesteps | 736000 |
| train/ | |
| entropy_loss | -0.385 |
| explained_variance | 0.959 |
| learning_rate | 0.0007 |
| n_updates | 36799 |
| policy_loss | 0.000849 |
| std | 0.301 |
| value_loss | 0.000285 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.63 |
| ep_rew_mean | -0.198 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 36900 |
| time_elapsed | 1681 |
| total_timesteps | 738000 |
| train/ | |
| entropy_loss | -0.382 |
| explained_variance | 0.944 |
| learning_rate | 0.0007 |
| n_updates | 36899 |
| policy_loss | -0.00428 |
| std | 0.301 |
| value_loss | 0.000339 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37000 |
| time_elapsed | 1686 |
| total_timesteps | 740000 |
| train/ | |
| entropy_loss | -0.361 |
| explained_variance | 0.363 |
| learning_rate | 0.0007 |
| n_updates | 36999 |
| policy_loss | -0.0392 |
| std | 0.299 |
| value_loss | 0.0132 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37100 |
| time_elapsed | 1690 |
| total_timesteps | 742000 |
| train/ | |
| entropy_loss | -0.351 |
| explained_variance | 0.963 |
| learning_rate | 0.0007 |
| n_updates | 37099 |
| policy_loss | -0.00179 |
| std | 0.297 |
| value_loss | 0.000346 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.98 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37200 |
| time_elapsed | 1694 |
| total_timesteps | 744000 |
| train/ | |
| entropy_loss | -0.361 |
| explained_variance | 0.943 |
| learning_rate | 0.0007 |
| n_updates | 37199 |
| policy_loss | -0.00243 |
| std | 0.298 |
| value_loss | 0.00101 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37300 |
| time_elapsed | 1699 |
| total_timesteps | 746000 |
| train/ | |
| entropy_loss | -0.364 |
| explained_variance | 0.357 |
| learning_rate | 0.0007 |
| n_updates | 37299 |
| policy_loss | -0.0236 |
| std | 0.299 |
| value_loss | 0.0194 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37400 |
| time_elapsed | 1704 |
| total_timesteps | 748000 |
| train/ | |
| entropy_loss | -0.38 |
| explained_variance | 0.965 |
| learning_rate | 0.0007 |
| n_updates | 37399 |
| policy_loss | -0.00457 |
| std | 0.3 |
| value_loss | 0.000168 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 4.17 |
| ep_rew_mean | -0.338 |
| success_rate | 0.99 |
| time/ | |
| fps | 438 |
| iterations | 37500 |
| time_elapsed | 1709 |
| total_timesteps | 750000 |
| train/ | |
| entropy_loss | -0.367 |
| explained_variance | 0.594 |
| learning_rate | 0.0007 |
| n_updates | 37499 |
| policy_loss | -0.0261 |
| std | 0.299 |
| value_loss | 0.00733 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.88 |
| ep_rew_mean | -0.317 |
| success_rate | 0.98 |
| time/ | |
| fps | 438 |
| iterations | 37600 |
| time_elapsed | 1713 |
| total_timesteps | 752000 |
| train/ | |
| entropy_loss | -0.364 |
| explained_variance | 0.0406 |
| learning_rate | 0.0007 |
| n_updates | 37599 |
| policy_loss | -0.198 |
| std | 0.299 |
| value_loss | 0.297 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37700 |
| time_elapsed | 1717 |
| total_timesteps | 754000 |
| train/ | |
| entropy_loss | -0.327 |
| explained_variance | 0.907 |
| learning_rate | 0.0007 |
| n_updates | 37699 |
| policy_loss | 0.00661 |
| std | 0.295 |
| value_loss | 0.00052 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.38 |
| ep_rew_mean | -0.265 |
| success_rate | 0.99 |
| time/ | |
| fps | 438 |
| iterations | 37800 |
| time_elapsed | 1722 |
| total_timesteps | 756000 |
| train/ | |
| entropy_loss | -0.331 |
| explained_variance | 0.859 |
| learning_rate | 0.0007 |
| n_updates | 37799 |
| policy_loss | 0.000418 |
| std | 0.296 |
| value_loss | 0.00112 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.95 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 37900 |
| time_elapsed | 1727 |
| total_timesteps | 758000 |
| train/ | |
| entropy_loss | -0.303 |
| explained_variance | 0.00162 |
| learning_rate | 0.0007 |
| n_updates | 37899 |
| policy_loss | 0.03 |
| std | 0.294 |
| value_loss | 0.00772 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.89 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38000 |
| time_elapsed | 1731 |
| total_timesteps | 760000 |
| train/ | |
| entropy_loss | -0.324 |
| explained_variance | 0.788 |
| learning_rate | 0.0007 |
| n_updates | 37999 |
| policy_loss | -0.0107 |
| std | 0.296 |
| value_loss | 0.00149 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38100 |
| time_elapsed | 1736 |
| total_timesteps | 762000 |
| train/ | |
| entropy_loss | -0.315 |
| explained_variance | 0.289 |
| learning_rate | 0.0007 |
| n_updates | 38099 |
| policy_loss | -0.0482 |
| std | 0.294 |
| value_loss | 0.0318 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38200 |
| time_elapsed | 1740 |
| total_timesteps | 764000 |
| train/ | |
| entropy_loss | -0.31 |
| explained_variance | 0.949 |
| learning_rate | 0.0007 |
| n_updates | 38199 |
| policy_loss | -0.00236 |
| std | 0.293 |
| value_loss | 0.000592 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.93 |
| ep_rew_mean | -0.239 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38300 |
| time_elapsed | 1745 |
| total_timesteps | 766000 |
| train/ | |
| entropy_loss | -0.302 |
| explained_variance | 0.953 |
| learning_rate | 0.0007 |
| n_updates | 38299 |
| policy_loss | 0.0026 |
| std | 0.292 |
| value_loss | 0.000193 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.13 |
| ep_rew_mean | -0.23 |
| success_rate | 0.99 |
| time/ | |
| fps | 438 |
| iterations | 38400 |
| time_elapsed | 1749 |
| total_timesteps | 768000 |
| train/ | |
| entropy_loss | -0.316 |
| explained_variance | 0.786 |
| learning_rate | 0.0007 |
| n_updates | 38399 |
| policy_loss | -0.00604 |
| std | 0.294 |
| value_loss | 0.00141 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38500 |
| time_elapsed | 1754 |
| total_timesteps | 770000 |
| train/ | |
| entropy_loss | -0.333 |
| explained_variance | 0.948 |
| learning_rate | 0.0007 |
| n_updates | 38499 |
| policy_loss | 0.000761 |
| std | 0.297 |
| value_loss | 0.000337 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38600 |
| time_elapsed | 1759 |
| total_timesteps | 772000 |
| train/ | |
| entropy_loss | -0.33 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 38599 |
| policy_loss | 0.00689 |
| std | 0.297 |
| value_loss | 0.000139 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38700 |
| time_elapsed | 1763 |
| total_timesteps | 774000 |
| train/ | |
| entropy_loss | -0.337 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 38699 |
| policy_loss | 0.0058 |
| std | 0.296 |
| value_loss | 0.000276 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.85 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 38800 |
| time_elapsed | 1767 |
| total_timesteps | 776000 |
| train/ | |
| entropy_loss | -0.316 |
| explained_variance | 0.959 |
| learning_rate | 0.0007 |
| n_updates | 38799 |
| policy_loss | 0.00115 |
| std | 0.295 |
| value_loss | 0.000444 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 38900 |
| time_elapsed | 1772 |
| total_timesteps | 778000 |
| train/ | |
| entropy_loss | -0.325 |
| explained_variance | 0.965 |
| learning_rate | 0.0007 |
| n_updates | 38899 |
| policy_loss | -0.00172 |
| std | 0.295 |
| value_loss | 0.000328 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.82 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 39000 |
| time_elapsed | 1776 |
| total_timesteps | 780000 |
| train/ | |
| entropy_loss | -0.314 |
| explained_variance | 0.837 |
| learning_rate | 0.0007 |
| n_updates | 38999 |
| policy_loss | -0.00189 |
| std | 0.293 |
| value_loss | 0.000779 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39100 |
| time_elapsed | 1781 |
| total_timesteps | 782000 |
| train/ | |
| entropy_loss | -0.301 |
| explained_variance | 0.963 |
| learning_rate | 0.0007 |
| n_updates | 39099 |
| policy_loss | -0.00315 |
| std | 0.292 |
| value_loss | 0.000218 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 39200 |
| time_elapsed | 1785 |
| total_timesteps | 784000 |
| train/ | |
| entropy_loss | -0.294 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 39199 |
| policy_loss | -0.00693 |
| std | 0.292 |
| value_loss | 0.000244 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.225 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39300 |
| time_elapsed | 1790 |
| total_timesteps | 786000 |
| train/ | |
| entropy_loss | -0.289 |
| explained_variance | 0.952 |
| learning_rate | 0.0007 |
| n_updates | 39299 |
| policy_loss | -0.00588 |
| std | 0.291 |
| value_loss | 0.000205 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.56 |
| ep_rew_mean | -0.199 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 39400 |
| time_elapsed | 1795 |
| total_timesteps | 788000 |
| train/ | |
| entropy_loss | -0.288 |
| explained_variance | 0.954 |
| learning_rate | 0.0007 |
| n_updates | 39399 |
| policy_loss | -0.00482 |
| std | 0.292 |
| value_loss | 0.000228 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.87 |
| ep_rew_mean | -0.225 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39500 |
| time_elapsed | 1799 |
| total_timesteps | 790000 |
| train/ | |
| entropy_loss | -0.295 |
| explained_variance | 0.683 |
| learning_rate | 0.0007 |
| n_updates | 39499 |
| policy_loss | 0.0195 |
| std | 0.293 |
| value_loss | 0.00273 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.63 |
| ep_rew_mean | -0.197 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39600 |
| time_elapsed | 1803 |
| total_timesteps | 792000 |
| train/ | |
| entropy_loss | -0.29 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 39599 |
| policy_loss | 0.000233 |
| std | 0.292 |
| value_loss | 0.000116 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.218 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 39700 |
| time_elapsed | 1808 |
| total_timesteps | 794000 |
| train/ | |
| entropy_loss | -0.259 |
| explained_variance | 0.971 |
| learning_rate | 0.0007 |
| n_updates | 39699 |
| policy_loss | 0.00478 |
| std | 0.29 |
| value_loss | 0.00036 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39800 |
| time_elapsed | 1813 |
| total_timesteps | 796000 |
| train/ | |
| entropy_loss | -0.249 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 39799 |
| policy_loss | 0.000653 |
| std | 0.289 |
| value_loss | 8.96e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 39900 |
| time_elapsed | 1817 |
| total_timesteps | 798000 |
| train/ | |
| entropy_loss | -0.23 |
| explained_variance | 0.977 |
| learning_rate | 0.0007 |
| n_updates | 39899 |
| policy_loss | -0.00167 |
| std | 0.287 |
| value_loss | 0.000226 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40000 |
| time_elapsed | 1822 |
| total_timesteps | 800000 |
| train/ | |
| entropy_loss | -0.221 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 39999 |
| policy_loss | -0.00577 |
| std | 0.286 |
| value_loss | 0.000235 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.98 |
| ep_rew_mean | -0.234 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40100 |
| time_elapsed | 1826 |
| total_timesteps | 802000 |
| train/ | |
| entropy_loss | -0.21 |
| explained_variance | 0.879 |
| learning_rate | 0.0007 |
| n_updates | 40099 |
| policy_loss | -0.0275 |
| std | 0.285 |
| value_loss | 0.00143 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.3 |
| ep_rew_mean | -0.254 |
| success_rate | 0.99 |
| time/ | |
| fps | 438 |
| iterations | 40200 |
| time_elapsed | 1831 |
| total_timesteps | 804000 |
| train/ | |
| entropy_loss | -0.186 |
| explained_variance | -0.108 |
| learning_rate | 0.0007 |
| n_updates | 40199 |
| policy_loss | 0.00239 |
| std | 0.283 |
| value_loss | 0.0101 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40300 |
| time_elapsed | 1835 |
| total_timesteps | 806000 |
| train/ | |
| entropy_loss | -0.157 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 40299 |
| policy_loss | -0.00328 |
| std | 0.282 |
| value_loss | 9.05e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.2 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40400 |
| time_elapsed | 1840 |
| total_timesteps | 808000 |
| train/ | |
| entropy_loss | -0.167 |
| explained_variance | 0.796 |
| learning_rate | 0.0007 |
| n_updates | 40399 |
| policy_loss | -0.023 |
| std | 0.283 |
| value_loss | 0.00171 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 40500 |
| time_elapsed | 1845 |
| total_timesteps | 810000 |
| train/ | |
| entropy_loss | -0.142 |
| explained_variance | 0.949 |
| learning_rate | 0.0007 |
| n_updates | 40499 |
| policy_loss | -0.00276 |
| std | 0.28 |
| value_loss | 0.000357 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40600 |
| time_elapsed | 1849 |
| total_timesteps | 812000 |
| train/ | |
| entropy_loss | -0.143 |
| explained_variance | 0.937 |
| learning_rate | 0.0007 |
| n_updates | 40599 |
| policy_loss | -0.00554 |
| std | 0.281 |
| value_loss | 0.000692 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40700 |
| time_elapsed | 1853 |
| total_timesteps | 814000 |
| train/ | |
| entropy_loss | -0.14 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 40699 |
| policy_loss | 0.00357 |
| std | 0.28 |
| value_loss | 9.45e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.223 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 40800 |
| time_elapsed | 1858 |
| total_timesteps | 816000 |
| train/ | |
| entropy_loss | -0.131 |
| explained_variance | 0.954 |
| learning_rate | 0.0007 |
| n_updates | 40799 |
| policy_loss | 0.00352 |
| std | 0.28 |
| value_loss | 0.000345 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 40900 |
| time_elapsed | 1863 |
| total_timesteps | 818000 |
| train/ | |
| entropy_loss | -0.13 |
| explained_variance | 0.933 |
| learning_rate | 0.0007 |
| n_updates | 40899 |
| policy_loss | -0.00231 |
| std | 0.28 |
| value_loss | 0.000889 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.81 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41000 |
| time_elapsed | 1868 |
| total_timesteps | 820000 |
| train/ | |
| entropy_loss | -0.116 |
| explained_variance | 0.987 |
| learning_rate | 0.0007 |
| n_updates | 40999 |
| policy_loss | 0.00132 |
| std | 0.278 |
| value_loss | 8.02e-05 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41100 |
| time_elapsed | 1872 |
| total_timesteps | 822000 |
| train/ | |
| entropy_loss | -0.124 |
| explained_variance | 0.971 |
| learning_rate | 0.0007 |
| n_updates | 41099 |
| policy_loss | 0.000992 |
| std | 0.278 |
| value_loss | 0.00029 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.199 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 41200 |
| time_elapsed | 1876 |
| total_timesteps | 824000 |
| train/ | |
| entropy_loss | -0.0987 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 41199 |
| policy_loss | 0.000891 |
| std | 0.276 |
| value_loss | 0.000143 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.68 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41300 |
| time_elapsed | 1881 |
| total_timesteps | 826000 |
| train/ | |
| entropy_loss | -0.0987 |
| explained_variance | 0.96 |
| learning_rate | 0.0007 |
| n_updates | 41299 |
| policy_loss | 0.00163 |
| std | 0.276 |
| value_loss | 0.000107 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41400 |
| time_elapsed | 1886 |
| total_timesteps | 828000 |
| train/ | |
| entropy_loss | -0.0829 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 41399 |
| policy_loss | -0.00275 |
| std | 0.275 |
| value_loss | 0.000234 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 41500 |
| time_elapsed | 1890 |
| total_timesteps | 830000 |
| train/ | |
| entropy_loss | -0.0809 |
| explained_variance | 0.952 |
| learning_rate | 0.0007 |
| n_updates | 41499 |
| policy_loss | -0.00517 |
| std | 0.275 |
| value_loss | 0.000606 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41600 |
| time_elapsed | 1895 |
| total_timesteps | 832000 |
| train/ | |
| entropy_loss | -0.105 |
| explained_variance | 0.98 |
| learning_rate | 0.0007 |
| n_updates | 41599 |
| policy_loss | -0.000973 |
| std | 0.277 |
| value_loss | 0.000201 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 41700 |
| time_elapsed | 1899 |
| total_timesteps | 834000 |
| train/ | |
| entropy_loss | -0.0852 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 41699 |
| policy_loss | -0.0106 |
| std | 0.275 |
| value_loss | 0.000455 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41800 |
| time_elapsed | 1904 |
| total_timesteps | 836000 |
| train/ | |
| entropy_loss | -0.0739 |
| explained_variance | 0.972 |
| learning_rate | 0.0007 |
| n_updates | 41799 |
| policy_loss | 0.00292 |
| std | 0.274 |
| value_loss | 0.000253 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 41900 |
| time_elapsed | 1909 |
| total_timesteps | 838000 |
| train/ | |
| entropy_loss | -0.0919 |
| explained_variance | 0.97 |
| learning_rate | 0.0007 |
| n_updates | 41899 |
| policy_loss | -8.65e-05 |
| std | 0.276 |
| value_loss | 0.000337 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42000 |
| time_elapsed | 1913 |
| total_timesteps | 840000 |
| train/ | |
| entropy_loss | -0.0935 |
| explained_variance | 0.987 |
| learning_rate | 0.0007 |
| n_updates | 41999 |
| policy_loss | 0.00186 |
| std | 0.276 |
| value_loss | 0.00012 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.206 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 42100 |
| time_elapsed | 1918 |
| total_timesteps | 842000 |
| train/ | |
| entropy_loss | -0.0812 |
| explained_variance | 0.968 |
| learning_rate | 0.0007 |
| n_updates | 42099 |
| policy_loss | -0.00331 |
| std | 0.275 |
| value_loss | 0.000255 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.47 |
| ep_rew_mean | -0.184 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42200 |
| time_elapsed | 1922 |
| total_timesteps | 844000 |
| train/ | |
| entropy_loss | -0.103 |
| explained_variance | 0.965 |
| learning_rate | 0.0007 |
| n_updates | 42199 |
| policy_loss | 0.00141 |
| std | 0.278 |
| value_loss | 0.000294 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.59 |
| ep_rew_mean | -0.194 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42300 |
| time_elapsed | 1926 |
| total_timesteps | 846000 |
| train/ | |
| entropy_loss | -0.102 |
| explained_variance | 0.982 |
| learning_rate | 0.0007 |
| n_updates | 42299 |
| policy_loss | -0.00151 |
| std | 0.277 |
| value_loss | 0.00012 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.79 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 438 |
| iterations | 42400 |
| time_elapsed | 1931 |
| total_timesteps | 848000 |
| train/ | |
| entropy_loss | -0.0848 |
| explained_variance | 0.887 |
| learning_rate | 0.0007 |
| n_updates | 42399 |
| policy_loss | -0.0313 |
| std | 0.275 |
| value_loss | 0.00107 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42500 |
| time_elapsed | 1935 |
| total_timesteps | 850000 |
| train/ | |
| entropy_loss | -0.0796 |
| explained_variance | 0.869 |
| learning_rate | 0.0007 |
| n_updates | 42499 |
| policy_loss | -0.00211 |
| std | 0.275 |
| value_loss | 0.0012 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.221 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42600 |
| time_elapsed | 1940 |
| total_timesteps | 852000 |
| train/ | |
| entropy_loss | -0.0697 |
| explained_variance | 0.942 |
| learning_rate | 0.0007 |
| n_updates | 42599 |
| policy_loss | -0.0029 |
| std | 0.275 |
| value_loss | 0.000326 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.81 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42700 |
| time_elapsed | 1945 |
| total_timesteps | 854000 |
| train/ | |
| entropy_loss | -0.0669 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 42699 |
| policy_loss | 0.00131 |
| std | 0.274 |
| value_loss | 0.000204 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.225 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42800 |
| time_elapsed | 1949 |
| total_timesteps | 856000 |
| train/ | |
| entropy_loss | -0.0512 |
| explained_variance | 0.991 |
| learning_rate | 0.0007 |
| n_updates | 42799 |
| policy_loss | -0.00586 |
| std | 0.273 |
| value_loss | 0.000201 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.212 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 42900 |
| time_elapsed | 1954 |
| total_timesteps | 858000 |
| train/ | |
| entropy_loss | -0.0256 |
| explained_variance | 0.936 |
| learning_rate | 0.0007 |
| n_updates | 42899 |
| policy_loss | 0.00432 |
| std | 0.27 |
| value_loss | 0.000606 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.81 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43000 |
| time_elapsed | 1958 |
| total_timesteps | 860000 |
| train/ | |
| entropy_loss | -0.0328 |
| explained_variance | 0.994 |
| learning_rate | 0.0007 |
| n_updates | 42999 |
| policy_loss | 0.00483 |
| std | 0.27 |
| value_loss | 0.000197 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43100 |
| time_elapsed | 1962 |
| total_timesteps | 862000 |
| train/ | |
| entropy_loss | -0.0639 |
| explained_variance | 0.987 |
| learning_rate | 0.0007 |
| n_updates | 43099 |
| policy_loss | 0.000862 |
| std | 0.273 |
| value_loss | 0.000102 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43200 |
| time_elapsed | 1967 |
| total_timesteps | 864000 |
| train/ | |
| entropy_loss | -0.0673 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 43199 |
| policy_loss | 0.00561 |
| std | 0.274 |
| value_loss | 0.00011 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43300 |
| time_elapsed | 1971 |
| total_timesteps | 866000 |
| train/ | |
| entropy_loss | -0.0433 |
| explained_variance | 0.98 |
| learning_rate | 0.0007 |
| n_updates | 43299 |
| policy_loss | 0.00229 |
| std | 0.272 |
| value_loss | 0.00018 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.81 |
| ep_rew_mean | -0.22 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43400 |
| time_elapsed | 1976 |
| total_timesteps | 868000 |
| train/ | |
| entropy_loss | -0.0342 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 43399 |
| policy_loss | 0.000593 |
| std | 0.271 |
| value_loss | 0.000192 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.71 |
| ep_rew_mean | -0.209 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43500 |
| time_elapsed | 1981 |
| total_timesteps | 870000 |
| train/ | |
| entropy_loss | -0.0294 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 43499 |
| policy_loss | -0.00546 |
| std | 0.27 |
| value_loss | 0.000167 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.64 |
| ep_rew_mean | -0.201 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43600 |
| time_elapsed | 1985 |
| total_timesteps | 872000 |
| train/ | |
| entropy_loss | -0.00564 |
| explained_variance | 0.956 |
| learning_rate | 0.0007 |
| n_updates | 43599 |
| policy_loss | 0.00187 |
| std | 0.268 |
| value_loss | 0.000628 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.199 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43700 |
| time_elapsed | 1990 |
| total_timesteps | 874000 |
| train/ | |
| entropy_loss | 0.00375 |
| explained_variance | 0.988 |
| learning_rate | 0.0007 |
| n_updates | 43699 |
| policy_loss | 0.00601 |
| std | 0.267 |
| value_loss | 0.000251 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43800 |
| time_elapsed | 1994 |
| total_timesteps | 876000 |
| train/ | |
| entropy_loss | -0.00438 |
| explained_variance | 0.926 |
| learning_rate | 0.0007 |
| n_updates | 43799 |
| policy_loss | 0.00492 |
| std | 0.268 |
| value_loss | 0.000762 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.57 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 43900 |
| time_elapsed | 1998 |
| total_timesteps | 878000 |
| train/ | |
| entropy_loss | -0.00183 |
| explained_variance | 0.965 |
| learning_rate | 0.0007 |
| n_updates | 43899 |
| policy_loss | 0.00791 |
| std | 0.268 |
| value_loss | 0.000486 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44000 |
| time_elapsed | 2003 |
| total_timesteps | 880000 |
| train/ | |
| entropy_loss | 0.0197 |
| explained_variance | 0.975 |
| learning_rate | 0.0007 |
| n_updates | 43999 |
| policy_loss | -0.000147 |
| std | 0.266 |
| value_loss | 0.000115 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44100 |
| time_elapsed | 2008 |
| total_timesteps | 882000 |
| train/ | |
| entropy_loss | 0.028 |
| explained_variance | 0.984 |
| learning_rate | 0.0007 |
| n_updates | 44099 |
| policy_loss | -0.00156 |
| std | 0.266 |
| value_loss | 0.000169 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.76 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44200 |
| time_elapsed | 2012 |
| total_timesteps | 884000 |
| train/ | |
| entropy_loss | 0.012 |
| explained_variance | 0.976 |
| learning_rate | 0.0007 |
| n_updates | 44199 |
| policy_loss | -0.000307 |
| std | 0.268 |
| value_loss | 0.000303 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.217 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44300 |
| time_elapsed | 2017 |
| total_timesteps | 886000 |
| train/ | |
| entropy_loss | 0.0243 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 44299 |
| policy_loss | 0.00122 |
| std | 0.267 |
| value_loss | 0.000149 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44400 |
| time_elapsed | 2021 |
| total_timesteps | 888000 |
| train/ | |
| entropy_loss | 0.0251 |
| explained_variance | 0.985 |
| learning_rate | 0.0007 |
| n_updates | 44399 |
| policy_loss | -0.0054 |
| std | 0.266 |
| value_loss | 0.000225 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44500 |
| time_elapsed | 2026 |
| total_timesteps | 890000 |
| train/ | |
| entropy_loss | 0.0174 |
| explained_variance | 0.957 |
| learning_rate | 0.0007 |
| n_updates | 44499 |
| policy_loss | 0.00267 |
| std | 0.267 |
| value_loss | 0.000176 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44600 |
| time_elapsed | 2030 |
| total_timesteps | 892000 |
| train/ | |
| entropy_loss | 0.0115 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 44599 |
| policy_loss | -0.00401 |
| std | 0.267 |
| value_loss | 0.000533 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44700 |
| time_elapsed | 2035 |
| total_timesteps | 894000 |
| train/ | |
| entropy_loss | 0.0179 |
| explained_variance | 0.969 |
| learning_rate | 0.0007 |
| n_updates | 44699 |
| policy_loss | 0.00262 |
| std | 0.267 |
| value_loss | 0.000373 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.78 |
| ep_rew_mean | -0.215 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44800 |
| time_elapsed | 2040 |
| total_timesteps | 896000 |
| train/ | |
| entropy_loss | 0.0349 |
| explained_variance | 0.99 |
| learning_rate | 0.0007 |
| n_updates | 44799 |
| policy_loss | 0.00382 |
| std | 0.266 |
| value_loss | 0.000146 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.96 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 44900 |
| time_elapsed | 2044 |
| total_timesteps | 898000 |
| train/ | |
| entropy_loss | 0.0426 |
| explained_variance | 0.908 |
| learning_rate | 0.0007 |
| n_updates | 44899 |
| policy_loss | -0.0122 |
| std | 0.264 |
| value_loss | 0.000955 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45000 |
| time_elapsed | 2048 |
| total_timesteps | 900000 |
| train/ | |
| entropy_loss | 0.0543 |
| explained_variance | 0.931 |
| learning_rate | 0.0007 |
| n_updates | 44999 |
| policy_loss | -0.00706 |
| std | 0.264 |
| value_loss | 0.000892 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.63 |
| ep_rew_mean | -0.205 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45100 |
| time_elapsed | 2053 |
| total_timesteps | 902000 |
| train/ | |
| entropy_loss | 0.0693 |
| explained_variance | 0.991 |
| learning_rate | 0.0007 |
| n_updates | 45099 |
| policy_loss | -0.00287 |
| std | 0.263 |
| value_loss | 0.000179 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.77 |
| ep_rew_mean | -0.219 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45200 |
| time_elapsed | 2058 |
| total_timesteps | 904000 |
| train/ | |
| entropy_loss | 0.089 |
| explained_variance | 0.986 |
| learning_rate | 0.0007 |
| n_updates | 45199 |
| policy_loss | -0.00645 |
| std | 0.262 |
| value_loss | 0.000206 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45300 |
| time_elapsed | 2062 |
| total_timesteps | 906000 |
| train/ | |
| entropy_loss | 0.0936 |
| explained_variance | 0.413 |
| learning_rate | 0.0007 |
| n_updates | 45299 |
| policy_loss | 0.02 |
| std | 0.262 |
| value_loss | 0.00864 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.67 |
| ep_rew_mean | -0.193 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45400 |
| time_elapsed | 2067 |
| total_timesteps | 908000 |
| train/ | |
| entropy_loss | 0.0966 |
| explained_variance | 0.838 |
| learning_rate | 0.0007 |
| n_updates | 45399 |
| policy_loss | -0.00367 |
| std | 0.262 |
| value_loss | 0.00839 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.226 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45500 |
| time_elapsed | 2071 |
| total_timesteps | 910000 |
| train/ | |
| entropy_loss | 0.0794 |
| explained_variance | 0.971 |
| learning_rate | 0.0007 |
| n_updates | 45499 |
| policy_loss | 0.00512 |
| std | 0.263 |
| value_loss | 0.000382 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.204 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45600 |
| time_elapsed | 2076 |
| total_timesteps | 912000 |
| train/ | |
| entropy_loss | 0.0763 |
| explained_variance | 0.958 |
| learning_rate | 0.0007 |
| n_updates | 45599 |
| policy_loss | -0.00114 |
| std | 0.264 |
| value_loss | 0.000379 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.73 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45700 |
| time_elapsed | 2080 |
| total_timesteps | 914000 |
| train/ | |
| entropy_loss | 0.0664 |
| explained_variance | 0.977 |
| learning_rate | 0.0007 |
| n_updates | 45699 |
| policy_loss | -0.0122 |
| std | 0.265 |
| value_loss | 0.000472 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.213 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45800 |
| time_elapsed | 2084 |
| total_timesteps | 916000 |
| train/ | |
| entropy_loss | 0.0611 |
| explained_variance | 0.983 |
| learning_rate | 0.0007 |
| n_updates | 45799 |
| policy_loss | -0.00488 |
| std | 0.266 |
| value_loss | 0.000284 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.202 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 45900 |
| time_elapsed | 2090 |
| total_timesteps | 918000 |
| train/ | |
| entropy_loss | 0.0724 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 45899 |
| policy_loss | 0.00129 |
| std | 0.264 |
| value_loss | 0.000296 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.195 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46000 |
| time_elapsed | 2094 |
| total_timesteps | 920000 |
| train/ | |
| entropy_loss | 0.0697 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 45999 |
| policy_loss | 0.00298 |
| std | 0.265 |
| value_loss | 0.00023 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.74 |
| ep_rew_mean | -0.21 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46100 |
| time_elapsed | 2098 |
| total_timesteps | 922000 |
| train/ | |
| entropy_loss | 0.0719 |
| explained_variance | 0.978 |
| learning_rate | 0.0007 |
| n_updates | 46099 |
| policy_loss | -0.00683 |
| std | 0.264 |
| value_loss | 0.000234 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.7 |
| ep_rew_mean | -0.203 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46200 |
| time_elapsed | 2103 |
| total_timesteps | 924000 |
| train/ | |
| entropy_loss | 0.0559 |
| explained_variance | 0.973 |
| learning_rate | 0.0007 |
| n_updates | 46199 |
| policy_loss | 0.00381 |
| std | 0.266 |
| value_loss | 0.000308 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.193 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46300 |
| time_elapsed | 2107 |
| total_timesteps | 926000 |
| train/ | |
| entropy_loss | 0.059 |
| explained_variance | 0.97 |
| learning_rate | 0.0007 |
| n_updates | 46299 |
| policy_loss | -0.000184 |
| std | 0.267 |
| value_loss | 0.000162 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.72 |
| ep_rew_mean | -0.207 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46400 |
| time_elapsed | 2112 |
| total_timesteps | 928000 |
| train/ | |
| entropy_loss | 0.0553 |
| explained_variance | 0.907 |
| learning_rate | 0.0007 |
| n_updates | 46399 |
| policy_loss | -0.0042 |
| std | 0.267 |
| value_loss | 0.000411 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.75 |
| ep_rew_mean | -0.211 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46500 |
| time_elapsed | 2116 |
| total_timesteps | 930000 |
| train/ | |
| entropy_loss | 0.0758 |
| explained_variance | 0.981 |
| learning_rate | 0.0007 |
| n_updates | 46499 |
| policy_loss | 0.00223 |
| std | 0.266 |
| value_loss | 0.000176 |
------------------------------------
-------------------------------------
| rollout/ | |
| ep_len_mean | 2.65 |
| ep_rew_mean | -0.202 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46600 |
| time_elapsed | 2121 |
| total_timesteps | 932000 |
| train/ | |
| entropy_loss | 0.0899 |
| explained_variance | 0.971 |
| learning_rate | 0.0007 |
| n_updates | 46599 |
| policy_loss | -0.000887 |
| std | 0.265 |
| value_loss | 0.000228 |
-------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3 |
| ep_rew_mean | -0.246 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46700 |
| time_elapsed | 2126 |
| total_timesteps | 934000 |
| train/ | |
| entropy_loss | 0.0902 |
| explained_variance | 0.945 |
| learning_rate | 0.0007 |
| n_updates | 46699 |
| policy_loss | -0.00746 |
| std | 0.264 |
| value_loss | 0.000521 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.62 |
| ep_rew_mean | -0.201 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46800 |
| time_elapsed | 2130 |
| total_timesteps | 936000 |
| train/ | |
| entropy_loss | 0.107 |
| explained_variance | 0.989 |
| learning_rate | 0.0007 |
| n_updates | 46799 |
| policy_loss | -0.00127 |
| std | 0.262 |
| value_loss | 0.000147 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 46900 |
| time_elapsed | 2134 |
| total_timesteps | 938000 |
| train/ | |
| entropy_loss | 0.116 |
| explained_variance | 0.977 |
| learning_rate | 0.0007 |
| n_updates | 46899 |
| policy_loss | -0.00467 |
| std | 0.261 |
| value_loss | 0.000167 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.89 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47000 |
| time_elapsed | 2139 |
| total_timesteps | 940000 |
| train/ | |
| entropy_loss | 0.104 |
| explained_variance | 0.689 |
| learning_rate | 0.0007 |
| n_updates | 46999 |
| policy_loss | -0.0475 |
| std | 0.262 |
| value_loss | 0.00324 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.228 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47100 |
| time_elapsed | 2143 |
| total_timesteps | 942000 |
| train/ | |
| entropy_loss | 0.106 |
| explained_variance | 0.963 |
| learning_rate | 0.0007 |
| n_updates | 47099 |
| policy_loss | -0.00519 |
| std | 0.261 |
| value_loss | 0.000527 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.37 |
| ep_rew_mean | -0.263 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47200 |
| time_elapsed | 2148 |
| total_timesteps | 944000 |
| train/ | |
| entropy_loss | 0.0892 |
| explained_variance | 0.855 |
| learning_rate | 0.0007 |
| n_updates | 47199 |
| policy_loss | -0.0134 |
| std | 0.263 |
| value_loss | 0.0247 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 4.03 |
| ep_rew_mean | -0.319 |
| success_rate | 0.99 |
| time/ | |
| fps | 439 |
| iterations | 47300 |
| time_elapsed | 2153 |
| total_timesteps | 946000 |
| train/ | |
| entropy_loss | 0.0874 |
| explained_variance | 0.877 |
| learning_rate | 0.0007 |
| n_updates | 47299 |
| policy_loss | 0.0133 |
| std | 0.263 |
| value_loss | 0.3 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 5.89 |
| ep_rew_mean | -0.478 |
| success_rate | 0.95 |
| time/ | |
| fps | 439 |
| iterations | 47400 |
| time_elapsed | 2157 |
| total_timesteps | 948000 |
| train/ | |
| entropy_loss | 0.0926 |
| explained_variance | 0.971 |
| learning_rate | 0.0007 |
| n_updates | 47399 |
| policy_loss | -0.0336 |
| std | 0.262 |
| value_loss | 0.111 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.12 |
| ep_rew_mean | -0.244 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47500 |
| time_elapsed | 2162 |
| total_timesteps | 950000 |
| train/ | |
| entropy_loss | 0.126 |
| explained_variance | 0.735 |
| learning_rate | 0.0007 |
| n_updates | 47499 |
| policy_loss | 0.0101 |
| std | 0.259 |
| value_loss | 0.0267 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.23 |
| ep_rew_mean | -0.243 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47600 |
| time_elapsed | 2166 |
| total_timesteps | 952000 |
| train/ | |
| entropy_loss | 0.138 |
| explained_variance | 0.554 |
| learning_rate | 0.0007 |
| n_updates | 47599 |
| policy_loss | -0.108 |
| std | 0.258 |
| value_loss | 0.071 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.2 |
| ep_rew_mean | -0.25 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 47700 |
| time_elapsed | 2170 |
| total_timesteps | 954000 |
| train/ | |
| entropy_loss | 0.156 |
| explained_variance | 0.583 |
| learning_rate | 0.0007 |
| n_updates | 47699 |
| policy_loss | -0.0225 |
| std | 0.256 |
| value_loss | 0.00441 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.85 |
| ep_rew_mean | -0.312 |
| success_rate | 0.98 |
| time/ | |
| fps | 439 |
| iterations | 47800 |
| time_elapsed | 2175 |
| total_timesteps | 956000 |
| train/ | |
| entropy_loss | 0.18 |
| explained_variance | 0.961 |
| learning_rate | 0.0007 |
| n_updates | 47799 |
| policy_loss | -0.0548 |
| std | 0.254 |
| value_loss | 0.0344 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 5.69 |
| ep_rew_mean | -0.459 |
| success_rate | 0.95 |
| time/ | |
| fps | 439 |
| iterations | 47900 |
| time_elapsed | 2180 |
| total_timesteps | 958000 |
| train/ | |
| entropy_loss | 0.17 |
| explained_variance | 0.573 |
| learning_rate | 0.0007 |
| n_updates | 47899 |
| policy_loss | -0.0315 |
| std | 0.254 |
| value_loss | 0.192 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3 |
| ep_rew_mean | -0.227 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48000 |
| time_elapsed | 2184 |
| total_timesteps | 960000 |
| train/ | |
| entropy_loss | 0.157 |
| explained_variance | 0.851 |
| learning_rate | 0.0007 |
| n_updates | 47999 |
| policy_loss | 0.128 |
| std | 0.255 |
| value_loss | 0.0995 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.07 |
| ep_rew_mean | -0.242 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48100 |
| time_elapsed | 2189 |
| total_timesteps | 962000 |
| train/ | |
| entropy_loss | 0.147 |
| explained_variance | -1.09 |
| learning_rate | 0.0007 |
| n_updates | 48099 |
| policy_loss | -0.0803 |
| std | 0.256 |
| value_loss | 0.0327 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.66 |
| ep_rew_mean | -0.198 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48200 |
| time_elapsed | 2193 |
| total_timesteps | 964000 |
| train/ | |
| entropy_loss | 0.14 |
| explained_variance | 0.97 |
| learning_rate | 0.0007 |
| n_updates | 48199 |
| policy_loss | 0.055 |
| std | 0.256 |
| value_loss | 0.017 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.24 |
| ep_rew_mean | -0.261 |
| success_rate | 0.99 |
| time/ | |
| fps | 439 |
| iterations | 48300 |
| time_elapsed | 2198 |
| total_timesteps | 966000 |
| train/ | |
| entropy_loss | 0.158 |
| explained_variance | -0.242 |
| learning_rate | 0.0007 |
| n_updates | 48299 |
| policy_loss | 0.00738 |
| std | 0.255 |
| value_loss | 0.0294 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.69 |
| ep_rew_mean | -0.214 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48400 |
| time_elapsed | 2203 |
| total_timesteps | 968000 |
| train/ | |
| entropy_loss | 0.146 |
| explained_variance | 0.91 |
| learning_rate | 0.0007 |
| n_updates | 48399 |
| policy_loss | -0.00295 |
| std | 0.256 |
| value_loss | 0.00115 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.222 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48500 |
| time_elapsed | 2207 |
| total_timesteps | 970000 |
| train/ | |
| entropy_loss | 0.154 |
| explained_variance | 0.827 |
| learning_rate | 0.0007 |
| n_updates | 48499 |
| policy_loss | -0.0043 |
| std | 0.255 |
| value_loss | 0.00174 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.21 |
| ep_rew_mean | -0.251 |
| success_rate | 0.99 |
| time/ | |
| fps | 439 |
| iterations | 48600 |
| time_elapsed | 2212 |
| total_timesteps | 972000 |
| train/ | |
| entropy_loss | 0.157 |
| explained_variance | 0.661 |
| learning_rate | 0.0007 |
| n_updates | 48599 |
| policy_loss | -0.0144 |
| std | 0.254 |
| value_loss | 0.00359 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.38 |
| ep_rew_mean | -0.246 |
| success_rate | 0.99 |
| time/ | |
| fps | 439 |
| iterations | 48700 |
| time_elapsed | 2216 |
| total_timesteps | 974000 |
| train/ | |
| entropy_loss | 0.177 |
| explained_variance | -5.77 |
| learning_rate | 0.0007 |
| n_updates | 48699 |
| policy_loss | -0.464 |
| std | 0.253 |
| value_loss | 1.34 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.96 |
| ep_rew_mean | -0.241 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48800 |
| time_elapsed | 2221 |
| total_timesteps | 976000 |
| train/ | |
| entropy_loss | 0.177 |
| explained_variance | 0.0534 |
| learning_rate | 0.0007 |
| n_updates | 48799 |
| policy_loss | 0.0143 |
| std | 0.253 |
| value_loss | 0.165 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.95 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 48900 |
| time_elapsed | 2226 |
| total_timesteps | 978000 |
| train/ | |
| entropy_loss | 0.178 |
| explained_variance | -0.464 |
| learning_rate | 0.0007 |
| n_updates | 48899 |
| policy_loss | -0.00229 |
| std | 0.253 |
| value_loss | 0.00948 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.06 |
| ep_rew_mean | -0.247 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49000 |
| time_elapsed | 2230 |
| total_timesteps | 980000 |
| train/ | |
| entropy_loss | 0.169 |
| explained_variance | 0.446 |
| learning_rate | 0.0007 |
| n_updates | 48999 |
| policy_loss | -0.0178 |
| std | 0.253 |
| value_loss | 0.00586 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.63 |
| ep_rew_mean | -0.281 |
| success_rate | 0.99 |
| time/ | |
| fps | 439 |
| iterations | 49100 |
| time_elapsed | 2235 |
| total_timesteps | 982000 |
| train/ | |
| entropy_loss | 0.167 |
| explained_variance | 0.477 |
| learning_rate | 0.0007 |
| n_updates | 49099 |
| policy_loss | 0.111 |
| std | 0.253 |
| value_loss | 0.674 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.89 |
| ep_rew_mean | -0.233 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49200 |
| time_elapsed | 2240 |
| total_timesteps | 984000 |
| train/ | |
| entropy_loss | 0.182 |
| explained_variance | 0.785 |
| learning_rate | 0.0007 |
| n_updates | 49199 |
| policy_loss | -0.00455 |
| std | 0.251 |
| value_loss | 0.00462 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.88 |
| ep_rew_mean | -0.232 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49300 |
| time_elapsed | 2244 |
| total_timesteps | 986000 |
| train/ | |
| entropy_loss | 0.191 |
| explained_variance | 0.797 |
| learning_rate | 0.0007 |
| n_updates | 49299 |
| policy_loss | -0.0071 |
| std | 0.251 |
| value_loss | 0.00193 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.8 |
| ep_rew_mean | -0.216 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49400 |
| time_elapsed | 2249 |
| total_timesteps | 988000 |
| train/ | |
| entropy_loss | 0.188 |
| explained_variance | 0.614 |
| learning_rate | 0.0007 |
| n_updates | 49399 |
| policy_loss | 0.0188 |
| std | 0.252 |
| value_loss | 0.00263 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.94 |
| ep_rew_mean | -0.234 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49500 |
| time_elapsed | 2253 |
| total_timesteps | 990000 |
| train/ | |
| entropy_loss | 0.204 |
| explained_variance | 0.919 |
| learning_rate | 0.0007 |
| n_updates | 49499 |
| policy_loss | 0.0103 |
| std | 0.251 |
| value_loss | 0.00115 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 3.09 |
| ep_rew_mean | -0.257 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49600 |
| time_elapsed | 2257 |
| total_timesteps | 992000 |
| train/ | |
| entropy_loss | 0.223 |
| explained_variance | 0.822 |
| learning_rate | 0.0007 |
| n_updates | 49599 |
| policy_loss | 0.00721 |
| std | 0.25 |
| value_loss | 0.00165 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.84 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49700 |
| time_elapsed | 2262 |
| total_timesteps | 994000 |
| train/ | |
| entropy_loss | 0.23 |
| explained_variance | 0.862 |
| learning_rate | 0.0007 |
| n_updates | 49699 |
| policy_loss | -0.00385 |
| std | 0.249 |
| value_loss | 0.000946 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.83 |
| ep_rew_mean | -0.208 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49800 |
| time_elapsed | 2267 |
| total_timesteps | 996000 |
| train/ | |
| entropy_loss | 0.247 |
| explained_variance | 0.974 |
| learning_rate | 0.0007 |
| n_updates | 49799 |
| policy_loss | -0.00113 |
| std | 0.247 |
| value_loss | 0.000659 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.86 |
| ep_rew_mean | -0.229 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 49900 |
| time_elapsed | 2272 |
| total_timesteps | 998000 |
| train/ | |
| entropy_loss | 0.255 |
| explained_variance | 0.932 |
| learning_rate | 0.0007 |
| n_updates | 49899 |
| policy_loss | -0.00734 |
| std | 0.246 |
| value_loss | 0.000622 |
------------------------------------
------------------------------------
| rollout/ | |
| ep_len_mean | 2.6 |
| ep_rew_mean | -0.192 |
| success_rate | 1 |
| time/ | |
| fps | 439 |
| iterations | 50000 |
| time_elapsed | 2276 |
| total_timesteps | 1000000 |
| train/ | |
| entropy_loss | 0.259 |
| explained_variance | 0.891 |
| learning_rate | 0.0007 |
| n_updates | 49999 |
| policy_loss | 0.0026 |
| std | 0.246 |
| value_loss | 0.000466 |
------------------------------------
<stable_baselines3.a2c.a2c.A2C at 0x79a4296c7e60>
# Save the model and  VecNormalize statistics when saving the agent
model.save("a2c-PandaReachDense-v3")
env.save("vec_normalize.pkl")
Evaluate the agent 📈
- Now that's our agent is trained, we need to check its performance.
- Stable-Baselines3 provides a method to do that:
evaluate_policy
from stable_baselines3.common.vec_env import DummyVecEnv, VecNormalize

# Load the saved statistics
eval_env = DummyVecEnv([lambda: gym.make("PandaReachDense-v3")])
eval_env = VecNormalize.load("vec_normalize.pkl", eval_env)

# We need to override the render_mode
eval_env.render_mode = "rgb_array"

#  do not update them at test time
eval_env.training = False
# reward normalization is not needed at test time
eval_env.norm_reward = False

# Load the agent
model = A2C.load("a2c-PandaReachDense-v3")

mean_reward, std_reward = evaluate_policy(model, eval_env)

print(f"Mean reward = {mean_reward:.2f} +/- {std_reward:.2f}")
Mean reward = -0.27 +/- 0.15
/usr/local/lib/python3.12/dist-packages/stable_baselines3/common/evaluation.py:70: UserWarning: Evaluation environment is not wrapped with a ``Monitor`` wrapper. This may result in reporting modified episode lengths and rewards, if other wrappers happen to modify these. Consider wrapping environment first with ``Monitor`` wrapper.
  warnings.warn(
Publish your trained model on the Hub 🔥
Now that we saw we got good results after the training, we can publish our trained model on the Hub with one line of code.
📚 The libraries documentation 👉 https://github.com/huggingface/huggingface_sb3/tree/main#hugging-face--x-stable-baselines3-v20
By using package_to_hub, as we already mentionned in the former units, you evaluate, record a replay, generate a model card of your agent and push it to the hub.
This way:
- You can showcase our work 🔥
- You can visualize your agent playing 👀
- You can share with the community an agent that others can use 💾
- You can access a leaderboard 🏆 to see how well your agent is performing compared to your classmates 👉 https://huggingface.co/spaces/huggingface-projects/Deep-Reinforcement-Learning-Leaderboard
To be able to share your model with the community there are three more steps to follow:
1️⃣ (If it's not already done) create an account to HF ➡ https://huggingface.co/join
2️⃣ Sign in and then, you need to store your authentication token from the Hugging Face website.
- Create a new token (https://huggingface.co/settings/tokens) with write role
- Copy the token
- Run the cell below and paste the token
# notebook_login()
# !git config --global credential.helper store
import os
from huggingface_hub import HfApi, login

def authenticate_huggingface():
    """Robust authentication for Colab, Kaggle, and Local environments."""
    hf_token = None

    # 1. Try Google Colab Secrets
    try:
        from google.colab import userdata
        try:
            hf_token = userdata.get("HF_TOKEN")
        except userdata.SecretNotFoundError:
            print("💡 Instruction: Add 'HF_TOKEN' to the Secrets tab (key icon) and enable access.")
    except (ImportError, ModuleNotFoundError):
        pass

    # 2. Try Kaggle Secrets (if not on Colab)
    if not hf_token:
        try:
            from kaggle_secrets import UserSecretsClient
            hf_token = UserSecretsClient().get_secret("HF_TOKEN")
        except (ImportError, ModuleNotFoundError, Exception):
            pass

    # 3. Try Environment Variables (Local/Docker)
    if not hf_token:
        hf_token = os.getenv("HF_TOKEN")

    if not hf_token:
        print("⚠️ No token found. Please set HF_TOKEN in your environment/secrets.")
        return False

    # Perform Login
    try:
        login(token=hf_token, add_to_git_credential=True)
        api = HfApi()
        user_info = api.whoami()
        print(f"✅ Logged in as: {user_info['name']}")
        return True
    except Exception as e:
        print(f"❌ Login failed: {e}")
        return False

# Execute
authenticate_huggingface()
/usr/local/lib/python3.12/dist-packages/jupyter_client/session.py:203: DeprecationWarning: datetime.datetime.utcnow() is deprecated and scheduled for removal in a future version. Use timezone-aware objects to represent datetimes in UTC: datetime.datetime.now(datetime.UTC).
  return datetime.utcnow().replace(tzinfo=utc)
✅ Logged in as: Chiz
True
If you don't want to use a Google Colab or a Jupyter Notebook, you need to use this command instead: huggingface-cli login
3️⃣ We're now ready to push our trained agent to the 🤗 Hub 🔥 using package_to_hub() function
For this environment, running this cell can take approximately 10min
from huggingface_sb3 import package_to_hub

package_to_hub(
    model=model,
    model_name=f"a2c-{env_id}",
    model_architecture="A2C",
    env_id=env_id,
    eval_env=eval_env,
    repo_id=f"Chiz/a2c-{env_id}", # Change the username
    commit_message="Initial commit",
)
ℹ This function will save, evaluate, generate a video of your agent,
create a model card and push everything to the hub. It might take up to 1min.
This is a work in progress: if you encounter a bug, please open an issue.
/usr/local/lib/python3.12/dist-packages/stable_baselines3/common/evaluation.py:70: UserWarning: Evaluation environment is not wrapped with a ``Monitor`` wrapper. This may result in reporting modified episode lengths and rewards, if other wrappers happen to modify these. Consider wrapping environment first with ``Monitor`` wrapper.
  warnings.warn(
Saving video to /tmp/tmpu6ri2q9x/-step-0-to-step-1000.mp4
Moviepy - Building video /tmp/tmpu6ri2q9x/-step-0-to-step-1000.mp4.
Moviepy - Writing video /tmp/tmpu6ri2q9x/-step-0-to-step-1000.mp4
/usr/local/lib/python3.12/dist-packages/jupyter_client/session.py:203: DeprecationWarning: datetime.datetime.utcnow() is deprecated and scheduled for removal in a future version. Use timezone-aware objects to represent datetimes in UTC: datetime.datetime.now(datetime.UTC).
  return datetime.utcnow().replace(tzinfo=utc)
Moviepy - Done !
Moviepy - video ready /tmp/tmpu6ri2q9x/-step-0-to-step-1000.mp4
✘ 'DummyVecEnv' object has no attribute 'video_recorder'
✘ We are unable to generate a replay of your agent, the package_to_hub
process continues
✘ Please open an issue at
https://github.com/huggingface/huggingface_sb3/issues
ℹ Pushing repo Chiz/a2c-PandaReachDense-v3 to the Hugging Face Hub
ℹ Your model is pushed to the Hub. You can view your model here:
https://huggingface.co/Chiz/a2c-PandaReachDense-v3/tree/main/
CommitInfo(commit_url='https://huggingface.co/Chiz/a2c-PandaReachDense-v3/commit/9b38e1c9e63873fcbe698c90ed05d92e7cfdc2bc', commit_message='Initial commit', commit_description='', oid='9b38e1c9e63873fcbe698c90ed05d92e7cfdc2bc', pr_url=None, repo_url=RepoUrl('https://huggingface.co/Chiz/a2c-PandaReachDense-v3', endpoint='https://huggingface.co', repo_type='model', repo_id='Chiz/a2c-PandaReachDense-v3'), pr_revision=None, pr_num=None)
from gymnasium.wrappers import RecordVideo
import gymnasium as gym

env = gym.make(env_id, render_mode="rgb_array")
env = RecordVideo(env, "./videos", name_prefix="a2c-PandaReachDense")

obs = env.reset()[0]
done = False
while not done:
    action, _ = model.predict(obs, deterministic=True)
    obs, _, terminated, truncated, _ = env.step(action)
    done = terminated or truncated

env.close()
from huggingface_hub import upload_file

upload_file(
    path_or_fileobj="./videos/a2c-PandaReachDense-episode-0.mp4",
    path_in_repo="replay.mp4",
    repo_id="Chiz/a2c-PandaReachDense-v3",
    repo_type="model"
)
CommitInfo(commit_url='https://huggingface.co/Chiz/a2c-PandaReachDense-v3/commit/19495ac79769b8d39a13d8714a7de5416ba6fd1f', commit_message='Upload replay.mp4 with huggingface_hub', commit_description='', oid='19495ac79769b8d39a13d8714a7de5416ba6fd1f', pr_url=None, repo_url=RepoUrl('https://huggingface.co/Chiz/a2c-PandaReachDense-v3', endpoint='https://huggingface.co', repo_type='model', repo_id='Chiz/a2c-PandaReachDense-v3'), pr_revision=None, pr_num=None)
Some additional challenges 🏆
The best way to learn is to try things by your own! Why not trying PandaPickAndPlace-v3?
If you want to try more advanced tasks for panda-gym, you need to check what was done using TQC or SAC (a more sample-efficient algorithm suited for robotics tasks). In real robotics, you'll use a more sample-efficient algorithm for a simple reason: contrary to a simulation if you move your robotic arm too much, you have a risk of breaking it.
PandaPickAndPlace-v1 (this model uses the v1 version of the environment): https://huggingface.co/sb3/tqc-PandaPickAndPlace-v1
And don't hesitate to check panda-gym documentation here: https://panda-gym.readthedocs.io/en/latest/usage/train_with_sb3.html
We provide you the steps to train another agent (optional):
- Define the environment called "PandaPickAndPlace-v3"
- Make a vectorized environment
- Add a wrapper to normalize the observations and rewards. Check the documentation
- Create the A2C Model (don't forget verbose=1 to print the training logs).
- Train it for 1M Timesteps
- Save the model and VecNormalize statistics when saving the agent
- Evaluate your agent
- Publish your trained model on the Hub 🔥 with
package_to_hub
See you on Unit 7! 🔥